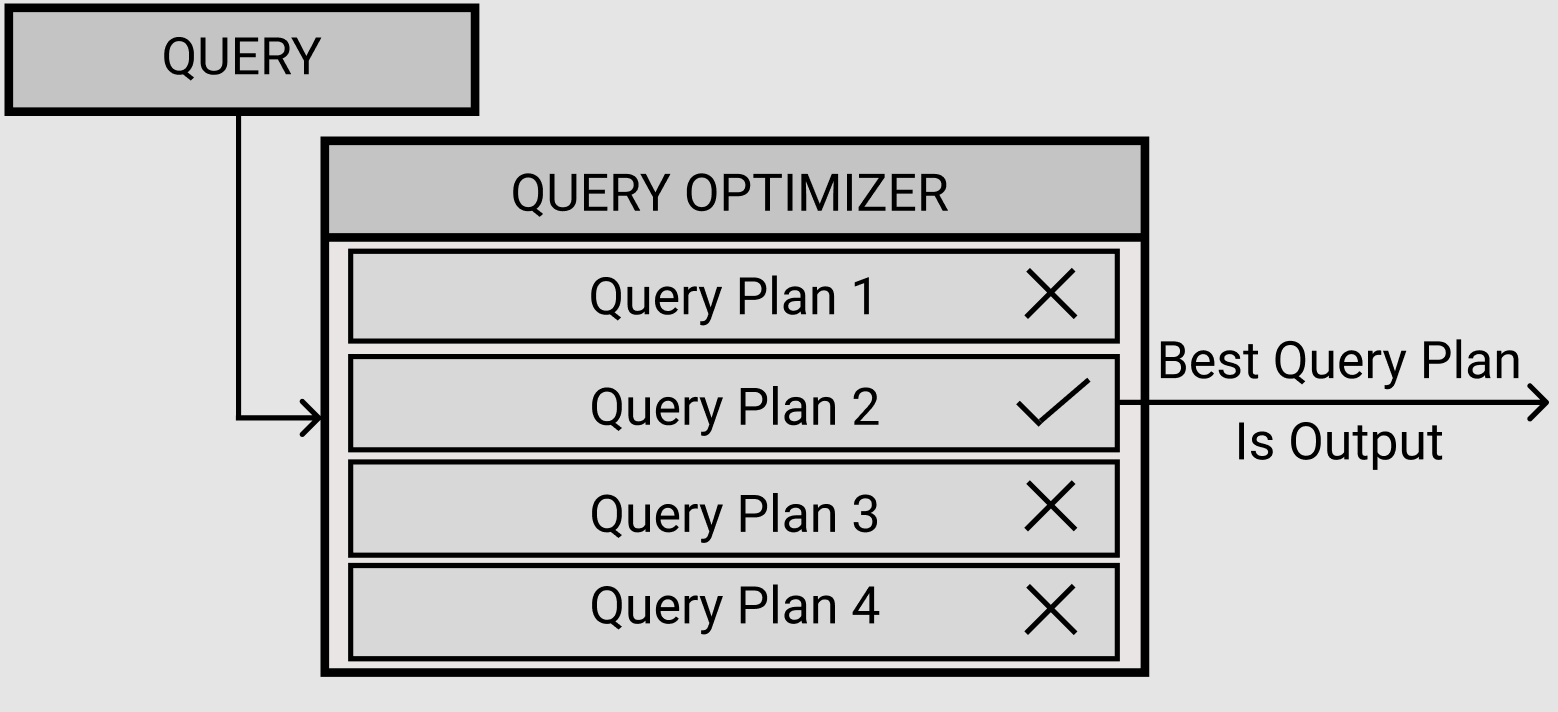
โมเดลที่ฝึกมาเพื่อวางแผนคิวรีโดยเฉพาะ อาจสร้าง query plan ได้เร็วกว่า PostgreSQL แต่ความเร็วอย่างเดียวไม่พอ ต้องดูความถูกต้องและความครอบคลุมของเวิร์กโหลดด้วย
ก่อนใช้งานจริงควรประเมินต้นทุนการรันโมเดล ความเสถียร และการดูแลระบบด้วย เพราะผลทดสอบในสภาพแวดล้อมหนึ่ง อาจไม่เหมือนกับงานฐานข้อมูลจริงครับ
เหตุผลที่การวางแผนคิวรีช้ากลายเป็นคอขวด
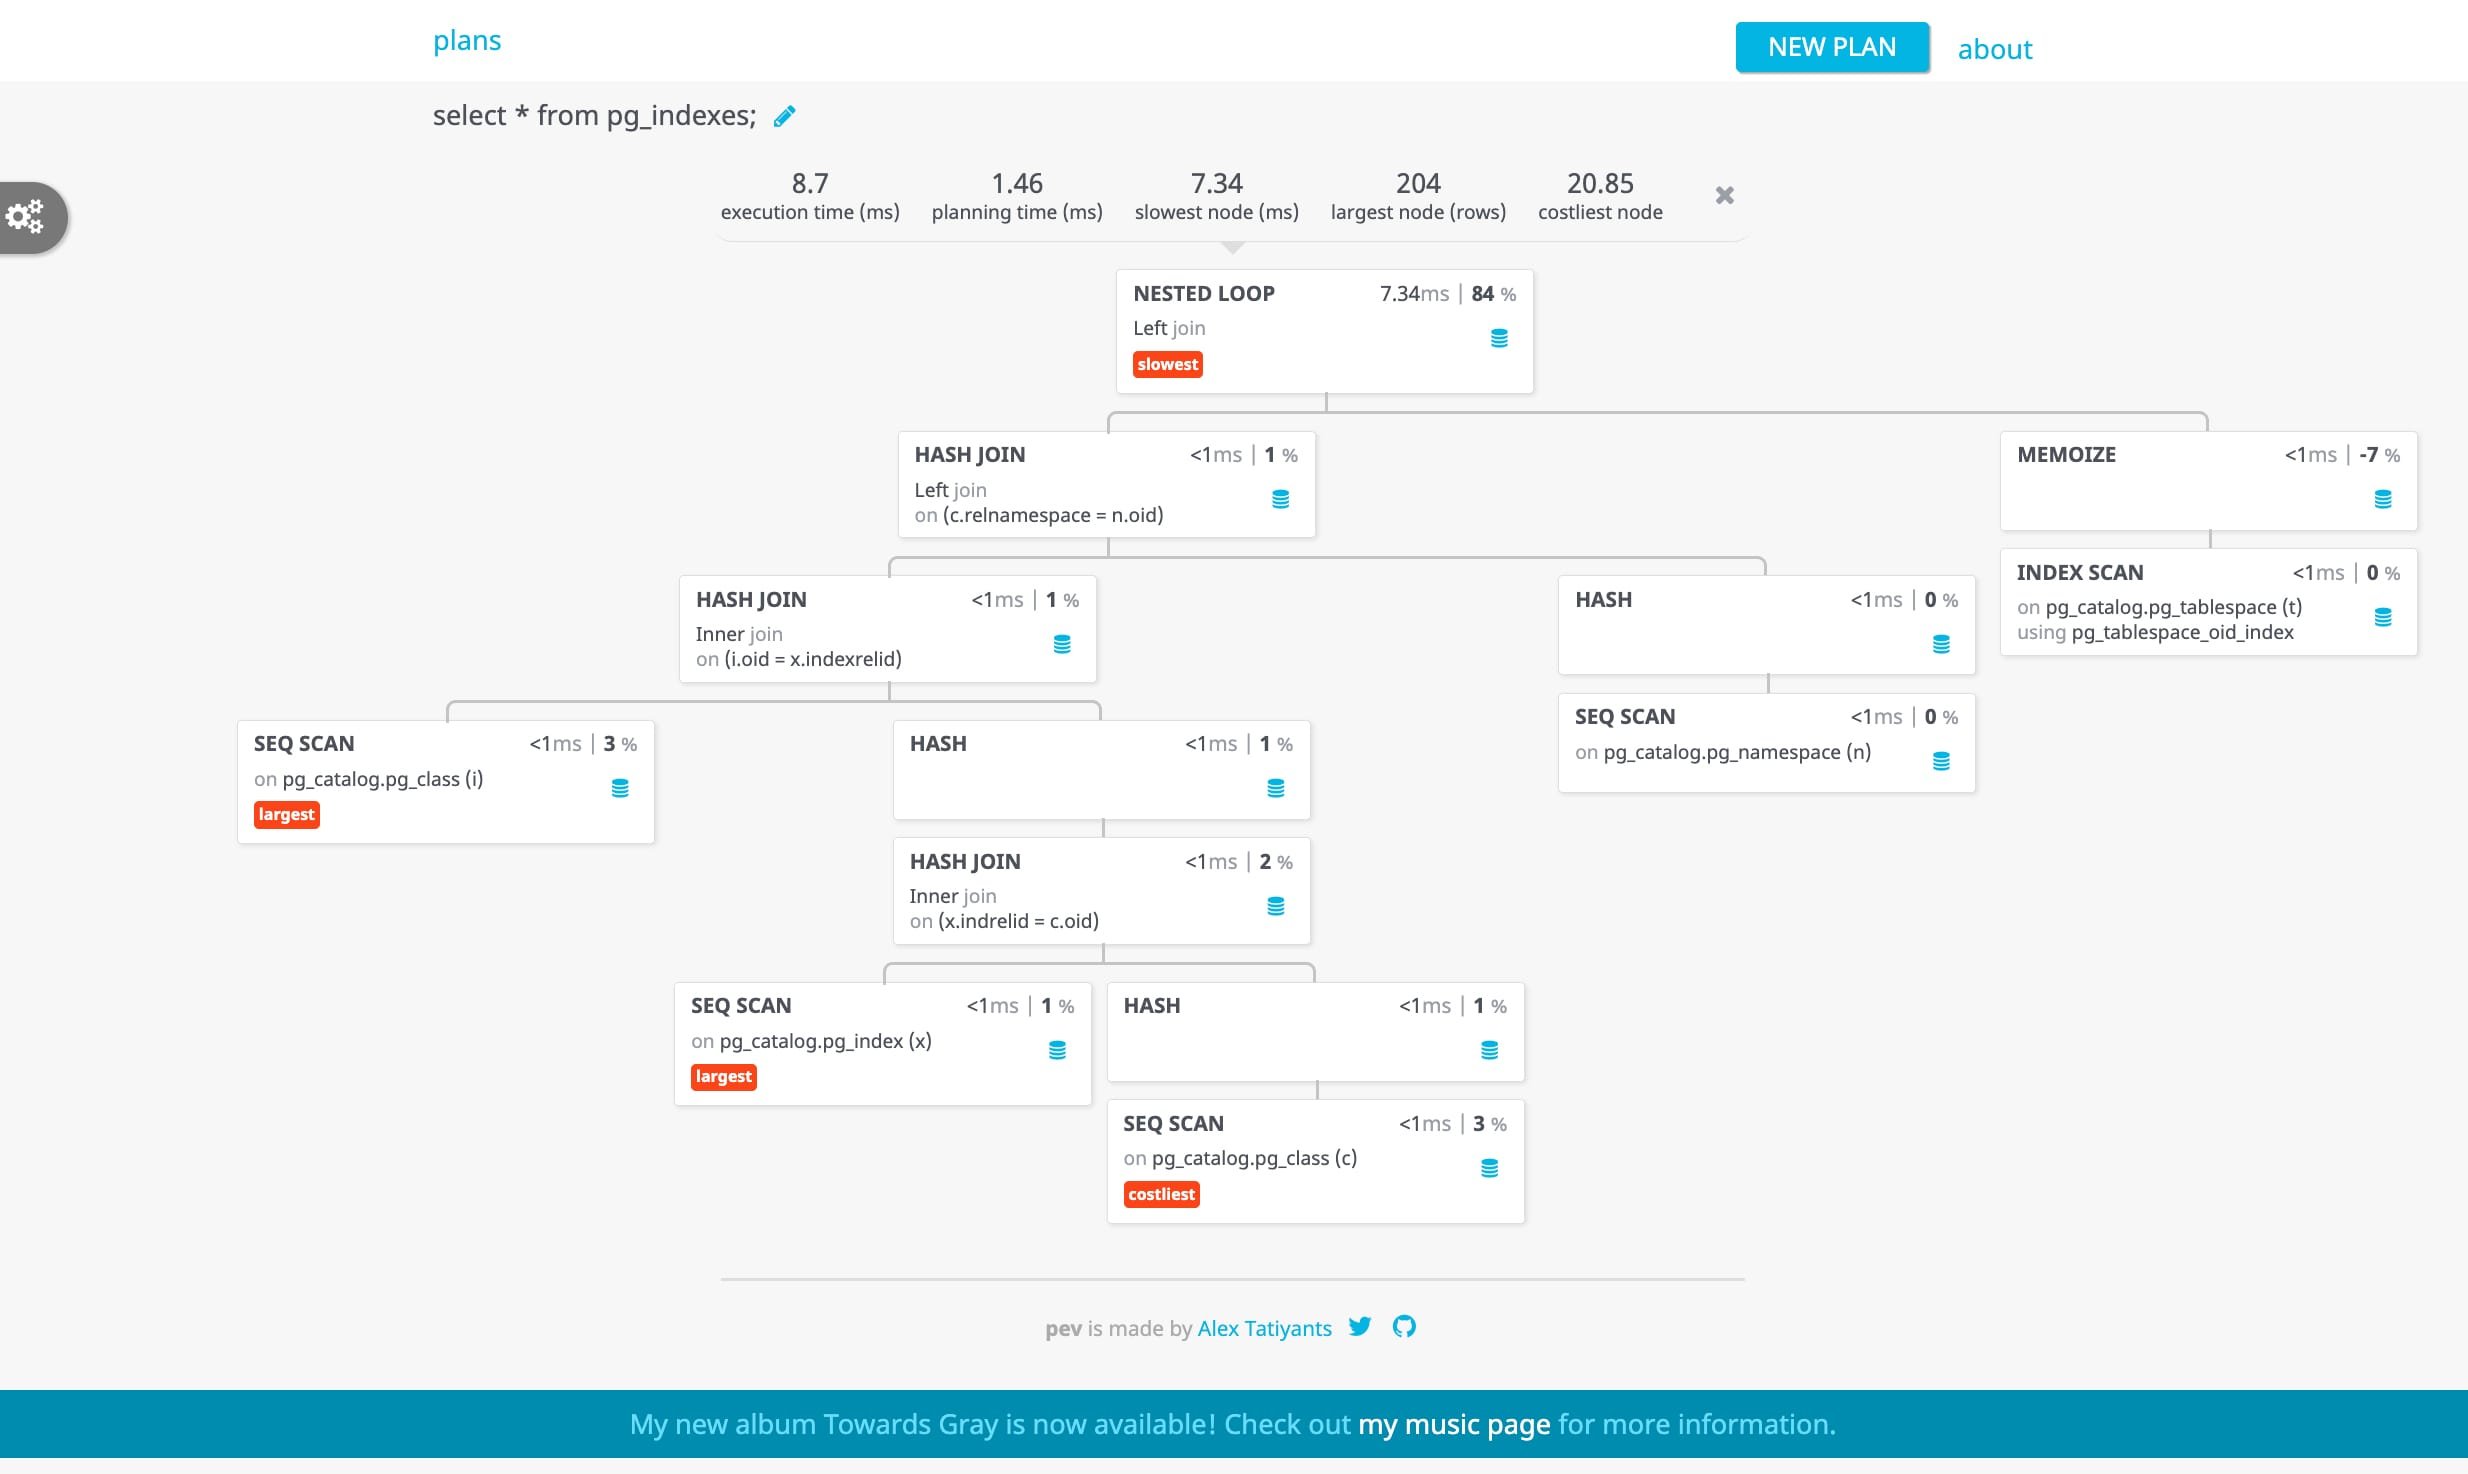
ในงานของทีม คิวรีซับซ้อนเริ่มใช้เวลานานขึ้น แม้ปรับแต่งฐานข้อมูลและฮาร์ดแวร์แล้วก็ตาม จุดที่ช้าจึงไม่ได้อยู่ที่การเขียน SQL อย่างเดียว แต่อยู่ที่การเลือกแผนการทำงานให้เหมาะกับข้อมูลและเงื่อนไขของคิวรี
ถ้าเลือกแผนไม่ดี ฐานข้อมูลอาจอ่านข้อมูลเกินจำเป็น หรือใช้ลำดับการทำงานที่ไม่เหมาะกับสถานการณ์จริง ปัญหานี้ทำให้การปรับเครื่องอย่างเดียวไม่พอ ต้องปรับปรุงวิธีวางแผนคิวรีควบคู่กันไปด้วย
โมเดลนี้อยู่ตรงไหนในภาพรวมของระบบฐานข้อมูล
โมเดล 4B นี้เป็นตัวช่วยสร้าง query plan โดยเสนอแนวทางให้ระบบเลือกวิธีรันคิวรีที่เหมาะขึ้น ไม่ใช่ฐานข้อมูลตัวใหม่ และไม่ได้เข้ามาแทน PostgreSQL ทั้งระบบ
เมื่อเทียบกับ query optimizer โมเดลทำหน้าที่คล้ายผู้ช่วยเสนอแผน ส่วน PostgreSQL ยังรับผิดชอบการเก็บข้อมูล ตรวจสอบความถูกต้อง และรันคำสั่งจริง เครื่องมือปรับจูนประสิทธิภาพจึงยังจำเป็นสำหรับดูปัญหาและวัดผลหลังเปลี่ยนแผนครับ
จาก PostgreSQL สู่โมเดล 4B: เปลี่ยนอะไรไปบ้าง
PostgreSQL สร้างแผนจากกฎ เครื่องมือ และสถิติของฐานข้อมูล ส่วนโมเดลที่ฝึกเฉพาะทางเรียนรู้รูปแบบ query เพื่อเสนอแผนที่เหมาะกับสถานการณ์มากขึ้น แต่ยังต้องตรวจสอบก่อนนำไปรันจริง
| Factor | PostgreSQL | โมเดลที่ฝึกเฉพาะทาง |
|---|---|---|
| วิธีสร้างแผน | ใช้ optimizer และกฎของระบบ | คาดการณ์แผนจากรูปแบบที่เรียนรู้ |
| การใช้สถิติฐานข้อมูล | อ้างอิงสถิติโดยตรง | อาจใช้บริบทที่เรียนรู้ร่วมด้วย |
| เวลาในการตอบสนอง | คาดเดาได้ตามระบบ | มีโอกาสตอบสนองเร็วขึ้น |
| ความยืดหยุ่น | ต้องปรับแต่งตามโครงสร้าง | ปรับตามรูปแบบ query ได้กว้างกว่า |
| ความเสี่ยงแผนผิด | ตรวจสอบได้เป็นระบบ | เสี่ยงเมื่อเจอ query นอกข้อมูลฝึก |
81% ที่เร็วขึ้นเกิดขึ้นในสถานการณ์ไหน
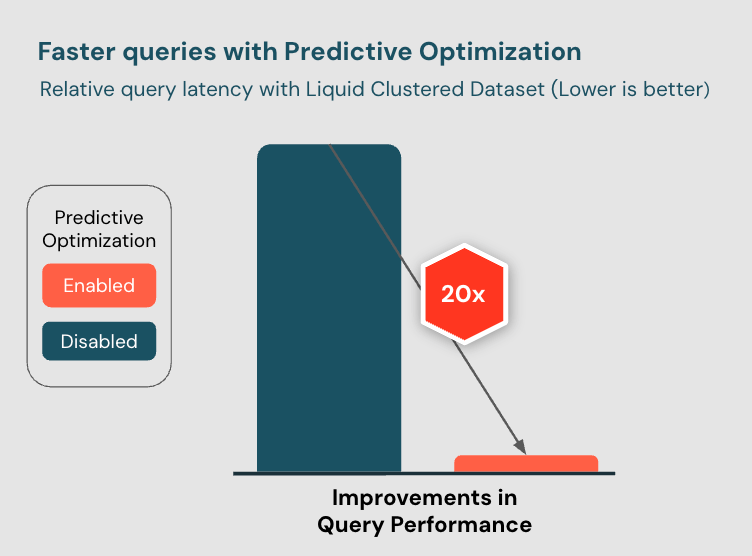
ตัวเลข 81% มาจากการทดสอบบน Join Order Benchmark (JOB) จำนวน 113 คิวรีที่เน้นการ join หลายตาราง บนฐานข้อมูล IMDb โดยวัดเป็นค่า geometric mean speedup ราว 1.81 เท่าเมื่อให้โมเดลเลือกแผนที่ดีที่สุดจาก 15 ตัวเลือก ส่วนงานวิจัยไม่ได้ระบุรุ่น PostgreSQL ที่ใช้ทดสอบไว้ชัดเจน จึงควรมองเป็นผลเฉพาะเงื่อนไขของ benchmark นี้ ไม่ใช่ทุก workload
เส้นทางคือ SQL → โมเดล 4B ช่วยเลือกแผน → query plan → PostgreSQL นำไปทำงาน หากไม่มีรายละเอียดการทดลองครบ ควรเลี่ยงการอ้างว่าเร็วขึ้นกับ workload จริงทุกแบบ
เมื่อฟีเจอร์ถูกทดสอบกับงานจริง
คิวรีที่มีหลายตารางและ join ซับซ้อนมีทางเลือกของแผนจำนวนมาก โมเดลอาจช่วยคัดแผนที่เหมาะได้เร็วขึ้น แต่ผลลัพธ์ขึ้นกับโครงสร้างตารางและสถิติของข้อมูล
ถ้าเวิร์กโหลดมีรูปแบบซ้ำ โมเดลจะใช้รูปแบบเดิมช่วยเลือกแผนได้ดีขึ้น แต่คิวรีที่เปลี่ยนเงื่อนไขบ่อยอาจไม่ได้ประโยชน์เท่าไร
ในระบบวิเคราะห์ข้อมูลหรือแดชบอร์ด การเลือกแผนที่เหมาะอาจลดเวลารอก่อนเห็นผลลัพธ์ โดยเฉพาะงานที่ถูกรันซ้ำเป็นประจำ แต่คอขวดอาจอยู่ที่ดิสก์หรือการส่งข้อมูลแทน
การทำงานร่วมกับ PostgreSQL ช่วยให้ยังใช้ฐานข้อมูลเดิมเป็นหลัก และให้โมเดลเข้ามาช่วยเลือก query plan เท่านั้น หากแผนที่โมเดลเสนอไม่เหมาะกับข้อมูลจริง ระบบควรมีทางกลับไปใช้แผนของ PostgreSQL ได้เสมอ
เทียบกับทางเลือกที่ทีมฐานข้อมูลมีอยู่แล้ว
โมเดล 4B เหมาะกับงานที่มีรูปแบบคิวรีซ้ำและต้องการลดเวลาวางแผน ส่วน optimizer มาตรฐานติดตั้งง่ายและไว้ใจได้กับเวิร์กโหลดทั่วไป การปรับแต่งด้วยมือเหมาะกับระบบที่ทีมรู้พฤติกรรมข้อมูลละเอียด แต่อาจดูแลยากเมื่อข้อมูลเปลี่ยน
| Factor | โมเดล 4B | Optimizer PostgreSQL | กฎเฉพาะระบบ |
|---|---|---|---|
| ความเร็ว | เร็วในคิวรีซ้ำ | สม่ำเสมอ | เร็วเมื่อจูนตรงจุด |
| ความถูกต้อง | ขึ้นกับข้อมูลฝึก | ไว้ใจได้ทั่วไป | ขึ้นกับการดูแล |
| ต้นทุน | ต้องมีทรัพยากรเพิ่ม | ใช้ของเดิม | ใช้เวลาทีม |
| ติดตั้ง | ซับซ้อนกว่า | พร้อมใช้ | ต้องเขียนและดูแล |
| เวิร์กโหลด | คิวรีซ้ำ รูปแบบชัด | งานหลากหลาย | ระบบเฉพาะทาง |
จุดเด่นที่เห็นได้ชัด และข้อจำกัดที่ต้องยอมรับ
โมเดล 4B มีโอกาสสร้าง query plan ได้เร็วในงานที่มีรูปแบบซ้ำ ช่วยลดภาระการปรับจูนด้วยมือ และเหมาะกับระบบที่มีรูปแบบคิวรีชัดเจน
ข้อดี
- +สร้างแผนคิวรีได้เร็ว
- +เหมาะกับงานที่มีรูปแบบซ้ำ
- +ลดภาระการปรับจูนด้วยมือ
ข้อเสีย
- −ข้อมูลฝึกอาจไม่ครอบคลุมทุกกรณี
- −ต้องพึ่งพาสคีมาและสถิติที่ถูกต้อง
- −ต้องใช้ทรัพยากรโครงสร้างพื้นฐาน
- −ตรวจสอบเหตุผลของแผนได้ยาก
ค่าใช้จ่ายจริงไม่ได้มีแค่ขนาดของโมเดล
ต้นทุนไม่ได้จบที่ค่า GPU หรือ server ยังมีค่าจัดเก็บและส่งข้อมูลสคีมา รวมถึงเวลาสร้างข้อมูลฝึกและชุดประเมินผลให้ครอบคลุมงานจริง
ใน production ต้องเผื่อ latency ที่เพิ่มขึ้น และระบบเฝ้าระวัง query plan ที่ผิดพลาดด้วย เมื่อโมเดลให้ผลลัพธ์ไม่เหมาะสม ทีมยังต้องดูแลระบบสำรองและตรวจสอบปัญหาอย่างต่อเนื่อง ดังนั้นค่าใช้จ่ายจริงจึงรวมทั้งโครงสร้างพื้นฐาน ข้อมูล และเวลาของทีมครับ
สิ่งที่บทความนี้ควรตรวจสอบก่อนเชื่อตัวเลข 81%
ต้องดูว่าชุดทดสอบมีขนาดและความหลากหลายพอจะสะท้อนงานจริงหรือไม่ รวมถึงนิยามของคำว่า “เร็วขึ้น” วัดเฉพาะเวลาสร้าง query plan หรือรวมเวลาประมวลผลจริงด้วย
ควรตรวจสอบความถูกต้องของผลลัพธ์ด้วย และต้องระบุชัดว่าเปรียบเทียบกับ PostgreSQL รุ่นใด ใช้ hardware และการตั้งค่าแบบไหน จึงจะประเมินตัวเลขนี้ได้อย่างเป็นธรรม
บทสรุป: ตัวเร่งการวางแผน หรือชั้นความซับซ้อนใหม่ของฐานข้อมูล
โมเดล 4B นี้น่าสนใจในฐานะตัวช่วยเฉพาะทางสำหรับระบบที่มีคิวรีจำนวนมากและรูปแบบซับซ้อน โดยงานวิจัยรายงานว่าสร้าง query plan ได้เร็วกว่า PostgreSQL ถึง 81% แต่ตัวเลขนี้ต้องดูควบคู่กับความถูกต้อง ความครอบคลุมของเวิร์กโหลด และต้นทุนการรันโมเดล
ขั้นถัดไปควรเริ่มจาก benchmark ของเวิร์กโหลดจริง แล้วทดสอบแบบ shadow mode โดยวัดทั้งความเร็ว ความถูกต้อง และต้นทุนรวม เพื่อดูว่าโมเดลช่วยงานได้จริงแค่ไหน โดยไม่เพิ่มความซับซ้อนให้ระบบเกินความคุ้มค่า