Mini-AGI เป็นโปรเจกต์โอเพนซอร์สที่โพสต์บน Show HN โดยผู้พัฒนา volotat อธิบายว่าเป็นโมเดลภาษาระดับไบต์ (byte-level language model) ที่ประกอบสถาปัตยกรรมของตัวเอง และฝึกจากศูนย์บนการ์ดจอ 8GB VRAM ใบเดียว จุดขายไม่ได้อยู่ที่ขนาดโมเดล แต่อยู่ที่ความสามารถเรียนรู้ข้อมูลใหม่ต่อเนื่องโดยไม่ลืมของเดิมทั้งหมด ซึ่งเป็นปัญหาคลาสสิกที่เรียกว่า catastrophic forgetting
ปัญหาที่ Mini-AGI พยายามแก้: โมเดลที่เรียนจบแล้วหยุดนิ่ง
โมเดลภาษาส่วนใหญ่ทำงานแบบ “เรียนครั้งเดียว ใช้ตลอดไป” คือฝึกจบแล้วนำไปดีพลอย ถ้าอยากให้รู้เรื่องใหม่ต้องเก็บข้อมูลชุดใหม่แล้วฝึกซ้ำทั้งกระบวนการ ซึ่งกินเวลาและทรัพยากร แถมการฝึกซ้ำแบบง่ายๆ มักทำให้โมเดลลืมความรู้เดิมไปด้วย เพราะน้ำหนักของโครงข่ายถูกปรับทับตามข้อมูลชุดใหม่ทั้งหมด
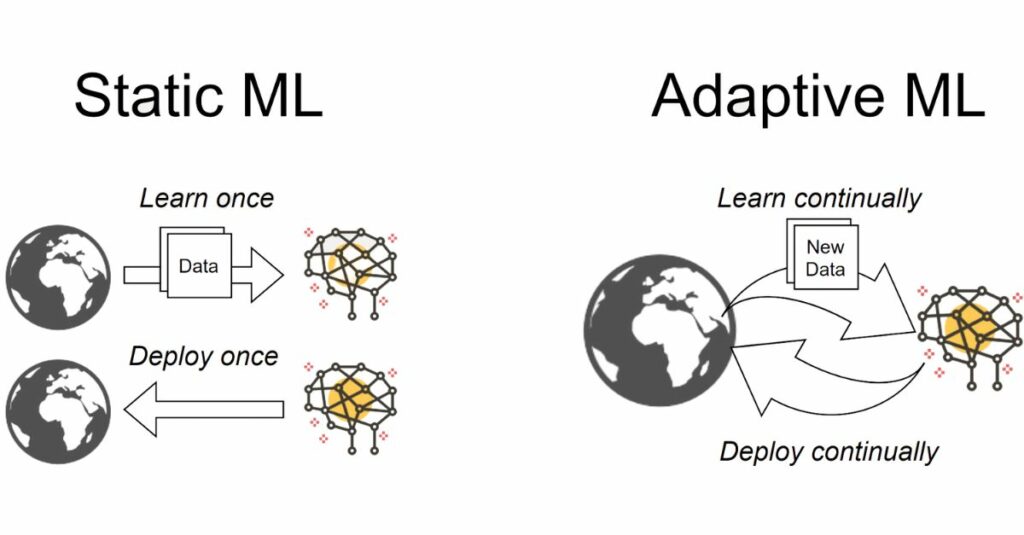
แนวคิด continual learning ที่ Mini-AGI ใช้คือฝั่งขวาของภาพ นั่นคือให้โมเดลรับข้อมูลใหม่และปรับตัวระหว่างใช้งานได้เรื่อยๆ แทนที่จะหยุดเรียนรู้หลังฝึกเสร็จรอบแรก แต่ปัญหาของแนวทางนี้ในงานวิจัยทั่วไปคือมักต้องแลกกับความรู้เดิม ยิ่งเรียนใหม่มากเท่าไหร่ ยิ่งเสี่ยงลืมของเก่ามากเท่านั้น
กลไกที่ทำให้ไม่ลืมของเดิม: learning rate ที่แตกต่างกันในแต่ละส่วน
จุดที่ทำให้ Mini-AGI ต่างจากการฝึกซ้ำทั่วไปคือการใช้ differential learning rate ระหว่างส่วน “trunk” ที่เก็บความรู้ร่วม กับส่วน “expert” ที่รับผิดชอบข้อมูลเฉพาะโดเมน ตามข้อมูลจากผู้พัฒนา เมื่อทดสอบให้โมเดลเรียนรู้ข้อมูลโดเมนใหม่ (นวนิยายยุควิกตอเรียนจากชุด PG19) การตั้ง trunk learning rate ไว้ที่ 0.1 เท่าของ expert learning rate ทำให้ได้อัตราส่วน “เรียนรู้ 3.25 nats ต่อทุก 1 nat ที่ลืม” เทียบกับวิธีที่ไม่มีการควบคุมซึ่งได้อัตราส่วนแค่ 0.23-0.25 เท่านั้น หรือดีขึ้นราวสิบกว่าเท่า
ผลอีกตัวที่ผู้พัฒนารายงานคือเมื่อสลับอ่านข้อมูลหลายโดเมนแบบ interleaved การตั้งค่านี้ทำให้โมเดลรักษาความรู้เดิมได้ 97.30% เทียบกับวิธีตั้ง learning rate เท่ากันหมดที่รักษาได้เพียง 74% ตัวเลขพวกนี้มาจากการทดลองในโปรเจกต์เอง ยังไม่ผ่านการรีวิวจากบุคคลที่สามหรือ paper ตีพิมพ์ จึงควรมองเป็นผลเบื้องต้นที่น่าสนใจ มากกว่าข้อสรุปสุดท้าย
สถาปัตยกรรมที่ยัดโมเดลลงในการ์ดจอ 8GB ได้อย่างไร
หัวใจของการประหยัด VRAM คือการแยกน้ำหนักโมเดลออกเป็นสองส่วน ส่วน core ที่ใช้งานตลอดเวลา กับส่วน expert จำนวนมากที่เก็บไว้บนดิสก์และโหลดขึ้นมาเฉพาะตอนจำเป็น ตามข้อมูลของโปรเจกต์ โมเดลรุ่นล่าสุดมีพารามิเตอร์รวม 540.1 ล้านตัว (core 8.27 ล้าน, router 0.17 ล้าน, expert 531.6 ล้าน) แต่ในการ์ดจอจะมี expert ทำงานพร้อมกันเพียง 32 ตัวจากทั้งหมด หรือคิดเป็นประมาณ 109 ล้านพารามิเตอร์เท่านั้น
สถาปัตยกรรมแบ่งเป็น 3 บล็อก คือบล็อก dense สองชั้นแรก กับบล็อกแบบ recurrent ที่เรียกซ้ำได้สูงสุด 24 รอบต่อการประมวลผลหนึ่งตัวอักษร พร้อมกลไก halting ที่ให้โมเดลเลือกเองว่าจะวนกี่รอบ (ปกติอยู่ที่ 4-14 รอบ) ส่วนการเลือก expert ใช้วิธี routing แบบ top-8 โดยไม่มีการกำหนดหัวข้อตายตัวล่วงหน้า ให้แต่ละ expert เรียนรู้ความถนัดของตัวเองจากการถูกเรียกใช้งานจริง
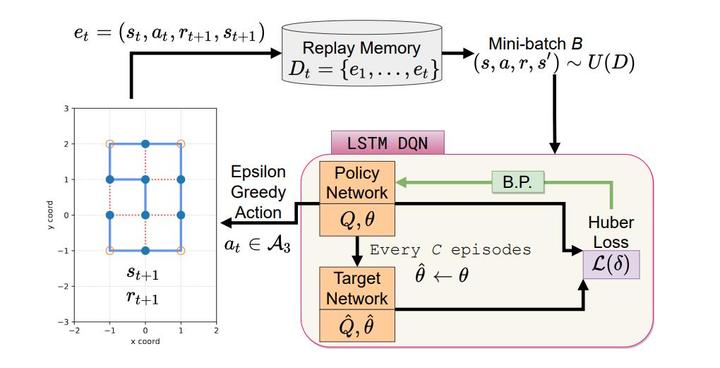
ภาพนี้เป็นตัวอย่างแนวคิด replay-based learning ที่วงการ continual learning ใช้กันทั่วไป ไม่ใช่แผนผังจริงของ Mini-AGI เพราะ Mini-AGI ไม่ได้ใช้ reinforcement learning หรือ replay buffer แบบนี้ แต่ยกมาเพื่อให้เห็นภาพว่าทำไมงานสายนี้ถึงต้องออกแบบกลไกจัดการ “ความจำ” ของโมเดลเป็นพิเศษ
| Factor | โมเดลฝึกครั้งเดียวทั่วไป | Mini-AGI |
|---|---|---|
| การเรียนรู้ข้อมูลใหม่ | ต้องเก็บข้อมูลแล้วฝึกซ้ำทั้งหมด | เรียนรู้ต่อเนื่องระหว่างใช้งานผ่าน differential learning rate |
| การใช้ VRAM | โหลดพารามิเตอร์ทั้งหมดพร้อมกัน | โหลดเฉพาะ 32 expert ที่จำเป็น (~109M จาก 540.1M) |
| ความเสี่ยงลืมความรู้เดิม | ขึ้นกับวิธีฝึกซ้ำที่เลือกใช้ | รายงานว่าเก็บความรู้เดิมได้ 97.30% เมื่อสลับโดเมน |
| การยืนยันผล | ส่วนใหญ่ผ่าน benchmark มาตรฐานที่รู้จักกันดี | ผลจากการทดลองในโปรเจกต์เอง ยังไม่ผ่านรีวิวภายนอก |
ตัวเลข benchmark ที่มีอยู่จริงตอนนี้
ผู้พัฒนารายงานผลจากการฝึกด้วยข้อมูล 456.2 ล้านตัวอักษรและ expert สะสม 174 ตัวไว้ดังนี้: held-out loss อยู่ที่ 0.7751 ± 0.0338 nats/char (เทียบเท่า 1.1182 bits/byte) ส่วน train loss อยู่ที่ 0.6422 nats/char และเมื่อวัดต่อรายวิชาพบว่าช่วงคะแนนกว้างมาก ตั้งแต่ 0.501 nats/char สำหรับข้อมูลหมากรุก ไปจนถึง 1.245 nats/char สำหรับข้อมูล Wikipedia
สำหรับการวัดแบบ out-of-distribution ผู้พัฒนาทดสอบกับชุด PG19 test split ได้ผล 2.450 bits/byte และเมื่อวิเคราะห์ scaling law ของโมเดลพบเลขชี้กำลัง -0.243 ซึ่งอยู่ระหว่างค่าที่ Kaplan et al. เคยรายงาน (0.095) กับค่าตาม Chinchilla (0.28) ตัวเลขเหล่านี้ยังต้องรอการทดสอบซ้ำโดยทีมอื่นเพื่อยืนยันความน่าเชื่อถือ เพราะทั้งหมดมาจาก README ของโปรเจกต์เดียว
จุดเด่นและข้อจำกัดที่ต้องชั่งน้ำหนัก
ข้อดี
- +ฝึกโมเดล 540M พารามิเตอร์บนการ์ดจอ 8GB VRAM ใบเดียวได้จริงตามที่ผู้พัฒนารายงาน
- +มีตัวเลขเปรียบเทียบชัดเจนว่า differential learning rate ช่วยลดการลืมความรู้เดิมได้หลายเท่า
ข้อเสีย
- −ตัวเลขทั้งหมดมาจากการทดลองของผู้พัฒนาเอง ยังไม่มี paper หรือรีวิวจากบุคคลที่สาม
- −held-out loss และ bits/byte ที่รายงานยังสูงกว่าโมเดลภาษาขนาดใหญ่ที่ผ่านการฝึกด้วยข้อมูลปริมาณมหาศาล
โมเดลนี้เหมาะกับคนที่อยากทดลองแนวคิด continual learning บนเครื่องส่วนตัวโดยไม่ต้องเช่า cloud GPU แพงๆ แต่ถ้าต้องการโมเดลที่ใช้งานได้ทันทีในระดับ production ตอนนี้ยังห่างไกลอยู่ครับ เพราะคุณภาพคำตอบยังไม่ถูกเทียบกับ benchmark มาตรฐานที่วงการ NLP ใช้กันทั่วไป เช่น MMLU หรือ HumanEval
ก่อนเอาไปใช้จริง ควรตรวจอะไรบ้าง
ใครที่คิดจะลองรันเอง ควรเริ่มจากตรวจสภาพแวดล้อมว่ามีการ์ดจอ 8GB VRAM ขึ้นไปจริง แล้วลองฝึกกับชุดข้อมูลเล็กๆ ก่อนเพื่อดูเวลาต่อรอบและการใช้ VRAM จริงบนเครื่องของตัวเอง เพราะตัวเลขที่ผู้พัฒนารายงานมาจากฮาร์ดแวร์ชุดเฉพาะ อาจไม่ตรงกับทุกรุ่นการ์ดจอ 8GB ในตลาด
ขั้นต่อไปคือทดสอบ catastrophic forgetting ด้วยชุดข้อมูลของตัวเอง ไม่ใช่แค่เชื่อตัวเลข 97.30% ที่รายงานไว้ เพราะผลอาจเปลี่ยนไปตามลักษณะข้อมูลที่ป้อนเข้าไป ควรวัดความแม่นยำก่อนและหลังให้เรียนรู้โดเมนใหม่ทุกครั้ง พร้อมเก็บ checkpoint ไว้ย้อนกลับได้เผื่อผลลัพธ์แย่ลงกว่าที่คาด
โดยรวมแล้ว Mini-AGI เป็นตัวอย่างที่ชัดเจนว่าการเรียนรู้ต่อเนื่องบนฮาร์ดแวร์จำกัดเริ่มเป็นไปได้จริง ไม่ใช่แค่แนวคิดในกระดาษ แต่ตัวเลขที่รายงานยังต้องผ่านการพิสูจน์ซ้ำโดยคนนอกก่อนจะเชื่อได้เต็มที่ว่าใช้แทนวิธีฝึกซ้ำแบบเดิมได้จริงในงานหลากหลายประเภท