Real-SWE คือเบนช์มาร์กใหม่จาก Specific Labs ที่เปิดตัวเมื่อเดือนกันยายน 2026 โดยทีมงาน Snagnik Das, Siddhant Paliwal และ Janak Sunil จุดต่างจากเบนช์มาร์กโค้ดดิ้งทั่วไปคือมันไม่ได้ใช้ repository สาธารณะหรือโจทย์ที่เตรียมไว้ล่วงหน้า แต่ดึงงานจริงจากโค้ดเบสองค์กรที่ได้รับอนุญาตให้ใช้ มาให้โมเดล AI แก้ปัญหาในบริบทที่ใกล้เคียงงานของวิศวกรจริงที่สุดเท่าที่จะทำได้
คะแนนที่ได้จึงน่าสนใจกว่าคะแนนบน public benchmark ทั่วไป เพราะสะท้อนว่าโมเดลรับมือกับ “ของจริง” ที่มีบริบทซับซ้อน กฎภายใน และผลกระทบทางธุรกิจได้แค่ไหน ไม่ใช่แค่แก้โจทย์ที่ถูกจัดวางมาให้สวยงาม
Real-SWE วัดอะไรที่ benchmark เดิมมองข้าม
จุดเน้นของ Real-SWE คือดูว่าโมเดลทำงาน “แบบวิศวกรที่ทำ production จริง” ได้แค่ไหน ไม่ใช่แค่เขียนโค้ดให้ผ่าน test เกณฑ์ที่ใช้ประเมินครอบคลุมสามด้านหลัก คือความสามารถในการไล่ตามระบบที่เป็นกรรมสิทธิ์และไม่มีข้อมูลอยู่บนอินเทอร์เน็ตสาธารณะ การรับมือกับการเปลี่ยนแปลงที่ส่งผลต่อธุรกิจโดยตรงอย่างระบบเรียกเก็บเงิน ภาษี หรือการย้ายข้อมูลลูกค้า และความเข้าใจ coding convention เฉพาะของแต่ละบริษัท
สามด้านนี้คือสิ่งที่ benchmark สาธารณะแทบไม่เคยจับได้ เพราะ repository โอเพนซอร์สไม่มีบริบทเชิงธุรกิจแบบนี้ให้ทดสอบ
เบื้องหลังชุดข้อมูล: โค้ดเบสองค์กรจริงที่ได้รับอนุญาตใช้งาน
Real-SWE สร้างจากโค้ดเบส production ที่มีลิขสิทธิ์ 3 ชุด ได้แก่ แพลตฟอร์มที่แข่งขันกับ Luma/Partiful ซึ่งมีผู้ใช้มากกว่า 200,000 คนและเคยติดอันดับ 100 อันดับแรกของ App Store, แพลตฟอร์ม fintech สำหรับผู้บริโภคที่ประมวลผล statement ธนาคารมากกว่า 100,000 รายการ และแพลตฟอร์ม AI สำหรับงานขายระดับองค์กรที่มี workflow ทางธุรกิจซับซ้อน
การใช้โค้ดเบสจริงแบบนี้ทำให้โจทย์ในชุดทดสอบมีบริบทที่ตรวจสอบไม่ได้จากอินเทอร์เน็ต และลดโอกาสที่โมเดลจะเคยเห็นคำตอบมาก่อนจากข้อมูลฝึกสาธารณะ
วิธีวัดผล: จาก sandbox ถึงตัวเลข pass@1
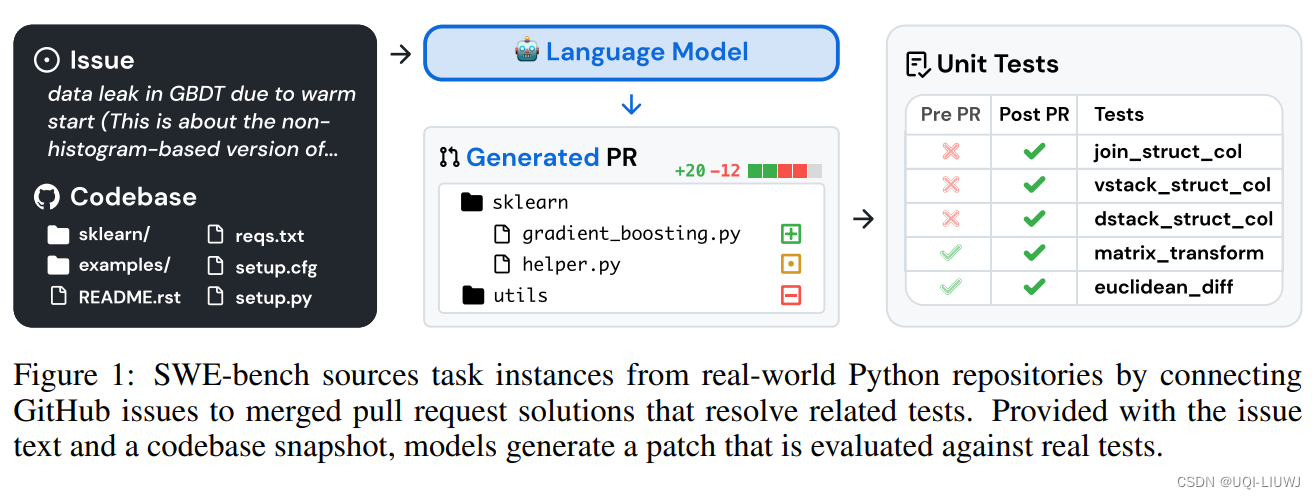
Real-SWE รันงานผ่าน sandbox แยกอิสระในรูปแบบ Harbor task ที่มีตัวตรวจสอบ (verifier) ฝังไว้สำหรับให้คะแนนตอนจบ แต่ละโจทย์ให้โมเดลลองทำได้สูงสุด 8 ครั้งแยกกัน แล้ววัดผลเป็น pass@1 หรืออัตราการแก้ปัญหาสำเร็จ โดยใช้ harness แบบเดียวกับที่วิศวกรองค์กรใช้งานจริง แทนที่จะทดสอบโมเดลแบบแยกตัวเดี่ยวๆ
โจทย์ใน Real-SWE มีคำสั่งค่อนข้างสั้น เฉลี่ยกลางอยู่ที่ 1,742 ตัวอักษร แต่ต้องแก้โค้ดข้ามไฟล์เฉลี่ยกลางถึง 11 ไฟล์ต่อโจทย์ เพราะตั้งใจไม่บอกรายละเอียดการทำงานไว้ล่วงหน้า ให้โมเดลต้องไปสำรวจเองจากโค้ดเบสและเครื่องมือรอบข้าง
ผลการจัดอันดับโมเดล เดือนกันยายน 2026
จากผลทดสอบที่ Specific Labs เผยแพร่ Fable 5.1 ทำอัตราการแก้ปัญหาสำเร็จได้สูงสุดในกลุ่มโมเดลที่ทดสอบ ตามด้วย GPT-6 Astra และ Gemini 3.8 Flash โดยตัวเลขต้นทุนต่อการรันก็แตกต่างกันไปตามแต่ละโมเดล
| อันดับ | โมเดล | อัตราแก้ปัญหาสำเร็จ (pass@1) | ต้นทุนเฉลี่ยต่อโจทย์ |
|---|---|---|---|
| 1 | Fable 5.1 | 38.8% | $6.96 |
| 2 | GPT-6 Astra | 33.8% | $4.67 |
| 3 | Gemini 3.8 Flash | 31.2% | $2.50 |
| 4 | GLM 5.3 | 28.8% | $5.12 |
| 5 | Grok 4.6 | 23.8% | $3.44 |
| 5 | Muse Spark 1.3 | 23.8% | $2.74 |
| 7 | Kimi K3 | 18.8% | $3.90 |
| 8 | GPT-5.6 Sol | 16.2% | $2.65 |
ตัวเลขเหล่านี้ชี้ให้เห็นว่าอัตราความสำเร็จสูงสุดในชุดทดสอบนี้ยังอยู่ที่ราวสี่สิบเปอร์เซ็นต์เท่านั้น ต่ำกว่าคะแนนที่โมเดลเดียวกันมักทำได้บน benchmark สาธารณะอย่างเห็นได้ชัด สะท้อนว่าโค้ดเบสองค์กรจริงยากกว่าที่คิด และต้นทุนต่อการรันก็ไม่ได้แปรผันตรงกับอันดับเสมอไป
Real-SWE เทียบกับ SWE-bench และ benchmark อื่น
| Factor | SWE-bench | Real-SWE |
|---|---|---|
| แหล่งที่มาของโค้ด | Repository โอเพนซอร์สสาธารณะ | โค้ดเบส production ที่ได้รับอนุญาตใช้ |
| ลักษณะคำสั่งโจทย์ | ระบุรายละเอียดค่อนข้างชัด | จงใจสั้นและไม่ระบุรายละเอียด ต้องสำรวจเอง |
| ขอบเขตการแก้โค้ด | มักจำกัดในไม่กี่ไฟล์ | เฉลี่ยกลางราว 11 ไฟล์ต่อโจทย์ |
| ความเสี่ยงข้อมูลปนเปื้อนจากการฝึก | ตรวจพบได้ในข้อมูลฝึกสาธารณะ | ลดลงเพราะโค้ดไม่เคยเปิดเผย |
ความยาวคำสั่งโจทย์เฉลี่ยกลางของ Real-SWE ที่ 1,742 ตัวอักษร อยู่ระหว่างเบนช์มาร์กกลุ่ม FrontierCode และ DeepSWE ที่ราว 992-2,056 ตัวอักษร กับ Terminal-Bench ที่ยาวถึง 31,584 ตัวอักษร แต่ Real-SWE กลับต้องแก้โค้ดข้ามไฟล์มากกว่าเบนช์มาร์กใกล้เคียงเกือบเท่าตัว คือเฉลี่ยกลาง 11 ไฟล์ เทียบกับราว 6 ไฟล์ในกลุ่มเปรียบเทียบ นี่คือส่วนที่ทำให้ Real-SWE ยากกว่าในทางปฏิบัติ แม้โจทย์จะดูสั้นกว่าก็ตาม
จุดแข็งและข้อจำกัดที่ต้องอ่านคู่กัน
Real-SWE ใกล้กับงานพัฒนา software จริงมากกว่าชุดทดสอบสาธารณะ ช่วยลดความเสี่ยงจากการวัดด้วยโจทย์ที่โมเดลอาจเคยเห็นมาก่อน และเปิดให้เห็นความสามารถที่ benchmark ทั่วไปประเมินไม่ครบ แต่ข้อจำกัดคือการตรวจสอบซ้ำทำได้ยาก เพราะโค้ดเบสทั้งสามชุดเป็นทรัพย์สินที่มีลิขสิทธิ์ ไม่เปิดให้บุคคลภายนอกตรวจสอบโดยตรง
ข้อดี
- +ใช้โค้ดเบส production จริงที่มีลิขสิทธิ์ ลดโอกาสปนเปื้อนจากข้อมูลฝึก
- +วัด pass@1 จากการรันจริงถึง 8 ครั้งต่อโจทย์ ให้ผลที่มีนัยสำคัญทางสถิติมากขึ้น
ข้อเสีย
- −ภายนอกตรวจสอบผลซ้ำเองไม่ได้ เพราะโค้ดเบสเป็นทรัพย์สินที่มีลิขสิทธิ์
- −ชุดข้อมูลมาจากโค้ดเบสเพียง 3 ชุด ผลอาจไม่ครอบคลุมทุกประเภทงานองค์กร
ก่อนเชื่อคะแนน ต้องถามว่า benchmark นี้แทนงานของเราได้แค่ไหน
คะแนน pass@1 ของ Real-SWE ควรอ่านเป็นสัญญาณเปรียบเทียบระหว่างโมเดล ไม่ใช่ตัวเลขที่รับประกันผลลัพธ์เมื่อนำไปใช้กับโค้ดเบสของทีมตัวเอง เพราะโค้ดเบสทั้งสามชุดที่ใช้ทดสอบมีลักษณะเฉพาะของตัวเอง ทั้งขนาด ภาษา และรูปแบบ workflow ซึ่งอาจต่างจากระบบที่ทีมคุณดูแลอยู่มาก
ถ้า codebase ของคุณมีกฎการอนุมัติ ข้อจำกัดด้านความปลอดภัย หรือ dependency ที่ซับซ้อนกว่าสามชุดที่ใช้ทดสอบ ผลลัพธ์จริงก็อาจต่างไปจากอันดับในตารางได้พอสมควร ทางที่ดีคือใช้ Real-SWE เพื่อเทียบแนวโน้มระหว่างโมเดลก่อน แล้วค่อยทดสอบซ้ำกับงานจริงของทีมก่อนตัดสินใจเลือกใช้งานจริงนะ
จากคะแนนบนกระดาษสู่เกณฑ์ตัดสินใจสำหรับทีมวิศวกรรม
Benchmark ที่ดีไม่ควรตอบแค่ว่าโมเดลไหนเก่งที่สุด แต่ควรช่วยทีมดูว่าโมเดลไหนเหมาะกับ codebase ระดับความเสี่ยง และกระบวนการทำงานขององค์กรมากที่สุด Real-SWE ทำสิ่งนี้ได้ดีตรงที่ดึงงานจากโค้ดเบส production จริงมาเป็นเกณฑ์วัด ทำให้เห็นช่องว่างระหว่างคะแนนบน public benchmark กับการใช้งานจริงได้ชัดขึ้น
อย่างไรก็ตาม อัตราความสำเร็จสูงสุดที่ยังอยู่แค่ราว 38.8% ก็เป็นเครื่องเตือนใจว่างานแบบวิศวกรองค์กรจริงยังเป็นโจทย์ที่ยากสำหรับโมเดล AI ปัจจุบัน คะแนนจาก Real-SWE จึงควรเป็นจุดเริ่มต้นของการประเมิน ไม่ใช่คำตอบสุดท้ายของการตัดสินใจเลือกใช้โมเดลในทีม