OpenAI จับคู่ Jalapeño ASIC กับ AMD EPYC “Turin” แทนที่จะรอ Nvidia Vera
Tom’s Hardware รายงานว่า OpenAI เริ่มใช้งาน Jalapeño ASIC ที่ออกแบบเองร่วมกับ Broadcom และ Celestica จริงแล้ว โดยวาง AMD EPYC “Turin” เป็น CPU โฮสต์ของระบบ ไม่ใช่ Nvidia Vera ตามที่หลายคนคาดไว้ก่อนหน้านี้ EPYC ทำหน้าที่เตรียมข้อมูล จัดคิวงาน และส่งต่อให้ Jalapeño ซึ่งเป็นตัวเร่งความเร็วสำหรับงาน inference โดยเฉพาะ
Richard Ho รองประธานฝ่ายฮาร์ดแวร์ของ OpenAI ให้สัมภาษณ์ว่า Nvidia Vera แบบสแตนด์อโลน “a little bit behind… on that maturity level” เมื่อเทียบกับความพร้อมที่ OpenAI ต้องการในตอนนี้ นี่คือเหตุผลหลักที่ทำให้ทีมฮาร์ดแวร์เลือก Turin แทน
เหตุผลของ Richard Ho: ทำไมเลือกของที่พิสูจน์แล้วมากกว่าของใหม่
การตัดสินใจนี้ Ho อธิบายว่าเป็นทางเลือกเชิงปฏิบัติ (pragmatic) มากกว่าการไล่ตามสเปกที่ดีที่สุด พาร์ตเนอร์ด้านการผลิตของ OpenAI มีความเชี่ยวชาญกับ ecosystem ของ Turin อยู่แล้ว ทำให้ความเสี่ยงด้านการรวมระบบ (integration risk) ต่ำกว่า และช่วยให้โครงการเดินตามตารางเวลาที่บีบรัดได้
พูดง่ายๆ คือ OpenAI เลือกความแน่นอนของแพลตฟอร์มที่พิสูจน์ตัวเองแล้วในสายการผลิตจริง มากกว่าการพนันกับแพลตฟอร์มใหม่ที่ยังต้องการเวลาพิสูจน์ตัวเอง แม้ Vera จะมีศักยภาพทางเทคนิคที่น่าสนใจก็ตาม
ส่องแร็ค Katsu และ Vindaloo: สเปกจริงเบื้องหลังคำว่า “โฮสต์”
ระบบของ OpenAI แบ่งเป็นสองแร็คที่ทำงานคู่กัน แร็ค “Katsu” บรรจุถาด CPU โฮสต์ 16 ถาด แต่ละถาดมี AMD EPYC “Turin” สองตัวพร้อม DRAM ราว 1.5TB, SSD แบบ NVMe และพอร์ตเครือข่ายระดับ 400G ส่วนแร็ค “Vindaloo” บรรจุถาดตัวเร่งความเร็ว 16 ถาดเช่นกัน แต่ละถาดมี Jalapeño ASIC หลายตัวเชื่อมกับถาด Katsu ที่จับคู่กันผ่านสาย PCIe ภายนอก
ระบบทั้งสองแร็ครวมกันกินไฟราวหลักแสนวัตต์ (แร็ค Katsu ใช้ไฟน้อยกว่าแร็ค Vindaloo มาก เพราะงานเร่งความเร็วส่วนใหญ่อยู่ที่ฝั่ง ASIC) ตัวเลขนี้สะท้อนว่า Turin ไม่ได้เป็นพระเอกด้านพลังงาน แต่เป็นตัวที่ทำให้ทั้งระบบทำงานได้ลื่นไหล
บทบาทของ EPYC Turin ในสายงาน inference ของ Jalapeño
ในงาน inference จริง EPYC Turin รับหน้าที่เตรียมข้อมูล จัดรูปแบบ input และจัดคิวงานก่อนส่งเข้า Jalapeño ASIC การแบ่งหน้าที่แบบนี้ช่วยให้ ASIC ไม่ต้องเสียเวลารอข้อมูล และรักษา throughput ให้สม่ำเสมอขึ้นเมื่อมีงานจำนวนมากพร้อมกัน
เมื่อขยายระบบเป็นหลายแร็ค EPYC Turin ยังทำหน้าที่ประสานงานระหว่างโหนด ขณะที่ Jalapeño โฟกัสที่งานคำนวณซ้ำๆ ที่ออกแบบมาให้ทำโดยเฉพาะ จุดที่ต้องระวังคือการสื่อสารระหว่างโหนด เพราะถ้าออกแบบไม่ดี latency และการใช้พลังงานจะเพิ่มขึ้นจากงานประสานระบบเอง ไม่ใช่จากตัวโมเดลเอง
เทียบแนวทาง Jalapeño + Turin กับทางเลือกอื่นในตลาด
| Factor | Jalapeño + EPYC Turin | Nvidia Vera (สแตนด์อโลน) | AMD GPU | Cloud accelerator ทั่วไป |
|---|---|---|---|---|
| ความพร้อมของแพลตฟอร์ม | โฮสต์เป็น x86 ที่พิสูจน์แล้วในสายการผลิตจริง | VP ของ OpenAI ระบุว่ายังตามหลังด้านความสมบูรณ์ | มี ecosystem กว้างและพร้อมใช้งาน | พร้อมใช้ทันทีผ่านผู้ให้บริการ |
| ซอฟต์แวร์ | ต้องพึ่ง stack เฉพาะของ OpenAI | ยังต้องพัฒนาต่อ | รองรับหลาย framework อยู่แล้ว | ใช้งานง่ายผ่าน API |
| การควบคุมระบบ | ควบคุมได้ทั้งฮาร์ดแวร์และซอฟต์แวร์ | ขึ้นกับ Nvidia | ยืดหยุ่นแต่ไม่ได้ออกแบบเฉพาะงาน | ผูกกับผู้ให้บริการ |
| ความเสี่ยงด้านตารางเวลา | ต่ำ เพราะพาร์ตเนอร์คุ้นเคยกับ Turin อยู่แล้ว | สูงกว่า เพราะแพลตฟอร์มยังใหม่ | ต่ำ เพราะเป็นชิปสำเร็จรูป | ต่ำ แต่แลกกับการควบคุมที่น้อยลง |
ตารางนี้ชี้ให้เห็นว่าการเลือก Turin ไม่ใช่เรื่องประสิทธิภาพดิบล้วนๆ แต่เป็นการประเมินความเสี่ยงทั้งระบบ ตั้งแต่ซัพพลายเชนไปจนถึงตารางการผลิตจริง
ตัวเลขประสิทธิภาพที่ OpenAI พอจะเปิดเผยได้
จากรายงานที่อ้างอิงการเปิดเผยของ OpenAI ระบบ Jalapeño ทำงานได้ราว 1.5–1.9 เท่าของงาน AI ต่อวัตต์ เมื่อเทียบกับชิป Nvidia รุ่นอ้างอิงที่ใช้เปรียบเทียบ ตัวเลขนี้เป็นตัวเลขที่บริษัทเลือกเปิดเผยเอง จึงควรมองเป็นข้อมูลจากฝั่งผู้ผลิต ไม่ใช่ผลทดสอบอิสระจากบุคคลที่สาม และยังไม่มี benchmark ภายนอกที่ตรวจสอบซ้ำได้ในตอนนี้
สิ่งที่ตัวเลขนี้ไม่ได้บอกคือประสิทธิภาพในงานที่หลากหลายกว่างาน inference เฉพาะทางของ OpenAI เอง หรือพฤติกรรมของระบบเมื่อ workload เปลี่ยนไปจากที่ออกแบบไว้
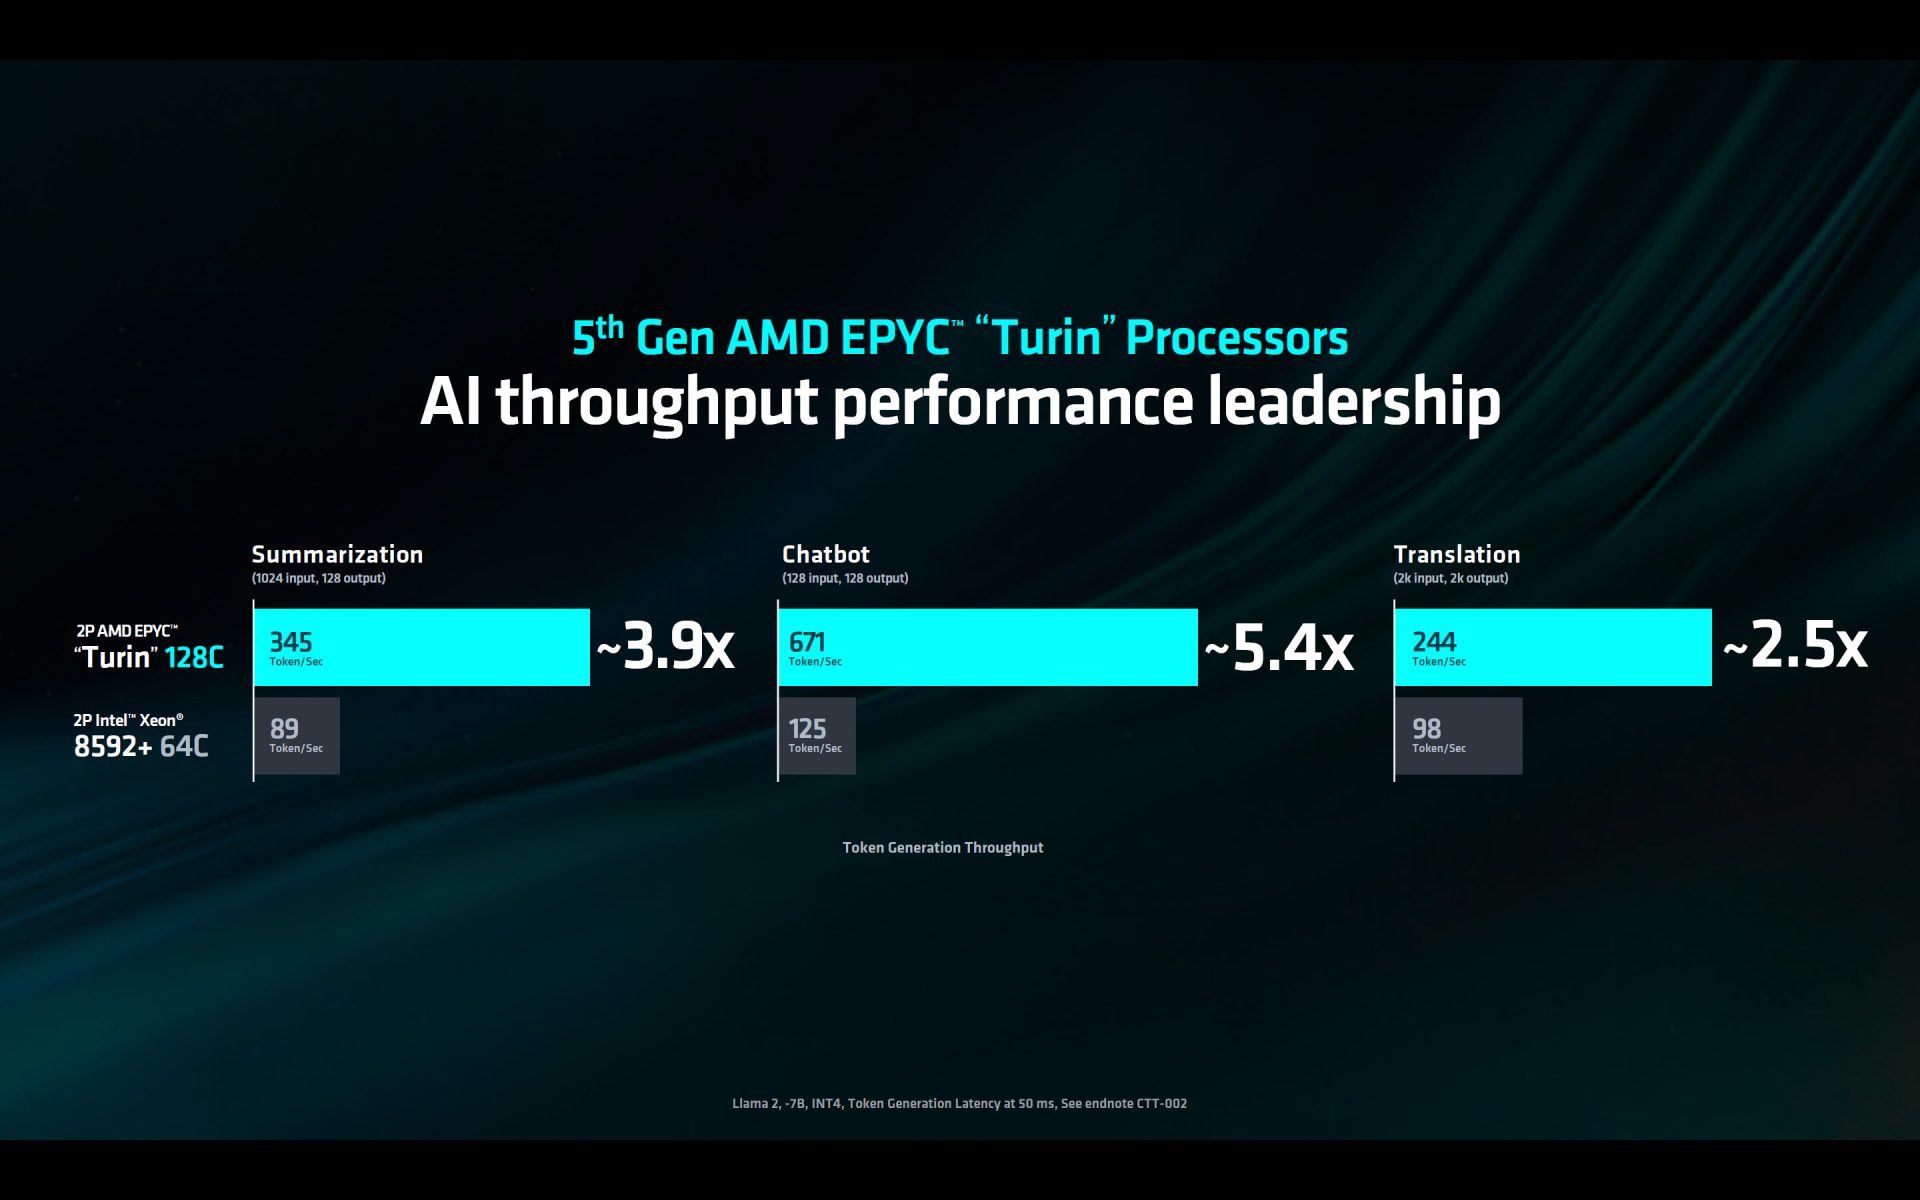
ตัวเลขในสไลด์นี้เป็นเบนช์มาร์กที่ AMD เผยแพร่เพื่อโปรโมต Turin เอง ไม่ใช่ตัวเลขจากระบบ Jalapeño โดยตรง แต่ช่วยให้เห็นภาพว่าทำไม EPYC Turin ถึงถูกเลือกเป็นโฮสต์ที่รองรับงาน AI ได้ดีกว่าซีพียูรุ่นก่อนในสายของ AMD เอง
จุดแข็งและข้อจำกัดของการพึ่ง ASIC ออกแบบเอง
Jalapeño เปิดทางให้ OpenAI ควบคุมฮาร์ดแวร์และซอฟต์แวร์ได้ละเอียดขึ้น ปรับแต่งตาม workload และลดการพึ่งพาซัพพลายเออร์รายเดียว แต่ข้อได้เปรียบนี้จะชัดเจนจริงก็ต่อเมื่อระบบทั้งชุดทำงานเข้ากันได้ตามที่ออกแบบไว้
ข้อดี
- +ควบคุมฮาร์ดแวร์และซอฟต์แวร์ได้มากขึ้น
- +ความเสี่ยงด้านตารางเวลาต่ำ เพราะ Turin เป็นแพลตฟอร์มที่พิสูจน์แล้ว
- +ปรับแต่งตาม workload inference เฉพาะทางได้ลึกกว่าชิปสำเร็จรูป
ข้อเสีย
- −ผูกกับซอฟต์แวร์สแต็กเฉพาะของ OpenAI เอง
- −ตัวเลขประสิทธิภาพยังมาจากฝั่งผู้ผลิต ไม่มี benchmark อิสระยืนยัน
- −การผลิตจำนวนมากและการดีบักยังเป็นความเสี่ยงของ ASIC ที่ออกแบบเอง
ต้นทุนที่ซ่อนอยู่หลังการออกแบบชิปเอง
ราคาชิป ASIC เป็นแค่จุดเริ่มต้น ยังมีค่าออกแบบ เทปเอาต์ การผลิต การทดสอบ ระบบระบายความร้อน และเครือข่ายที่ต้องรองรับการทำงานของทั้งแร็ค Katsu และ Vindaloo ฝั่งซอฟต์แวร์ก็มีต้นทุนจากการพอร์ตและดูแลระบบให้เข้ากับสถาปัตยกรรมเฉพาะ ไม่ว่าจะเป็น firmware, driver หรือระบบ monitoring ที่ต้องดูแลต่อเนื่อง
ระยะยาวต้องเผื่องบบำรุงรักษาและความเสี่ยงจากการล็อกกับสถาปัตยกรรมเดียว ถ้า workload ในอนาคตเปลี่ยนไปจากที่ Jalapeño ถูกออกแบบมา ระบบที่เคยคุ้มอาจปรับใช้งานได้ยากกว่าการใช้ฮาร์ดแวร์มาตรฐานทั่วไป
สรุป: ทิศทางโครงสร้างพื้นฐาน AI หลัง Jalapeño
แก่นของข่าวนี้ไม่ใช่แค่การเลือก Jalapeño แทน Vera แต่คือการแยกบทบาทระหว่าง accelerator กับ host CPU ให้ชัดเจนขึ้น และสะท้อนว่า OpenAI มองความเสี่ยงด้านตารางเวลาการผลิตสำคัญพอๆ กับประสิทธิภาพดิบ
ต่อจากนี้ควรติดตาม benchmark จากบุคคลที่สาม การเปิดเผยซอฟต์แวร์เพิ่มเติม และหลักฐานการใช้งานในระดับ production เพราะสิ่งเหล่านี้จะบอกได้ว่าสถาปัตยกรรม Jalapeño + Turin ตอบโจทย์งานจริงได้คุ้มและเสถียรแค่ไหนในระยะยาว