เอกสารศาลที่เพิ่งถูกเปิดเผยเมื่อเดือนกันยายน 2026 จากคดีที่ The New York Times ฟ้อง OpenAI และ Microsoft เผยให้เห็นว่าทั้งสองบริษัทตระหนักมาตั้งแต่ต้นว่าการดึงเนื้อหาเว็บมาเทรนโมเดล แล้วให้ AI ตอบคำถามแทนต้นทาง กำลังสร้างวงจรที่บั่นทอนทั้งเว็บและคุณภาพของโมเดลเอง
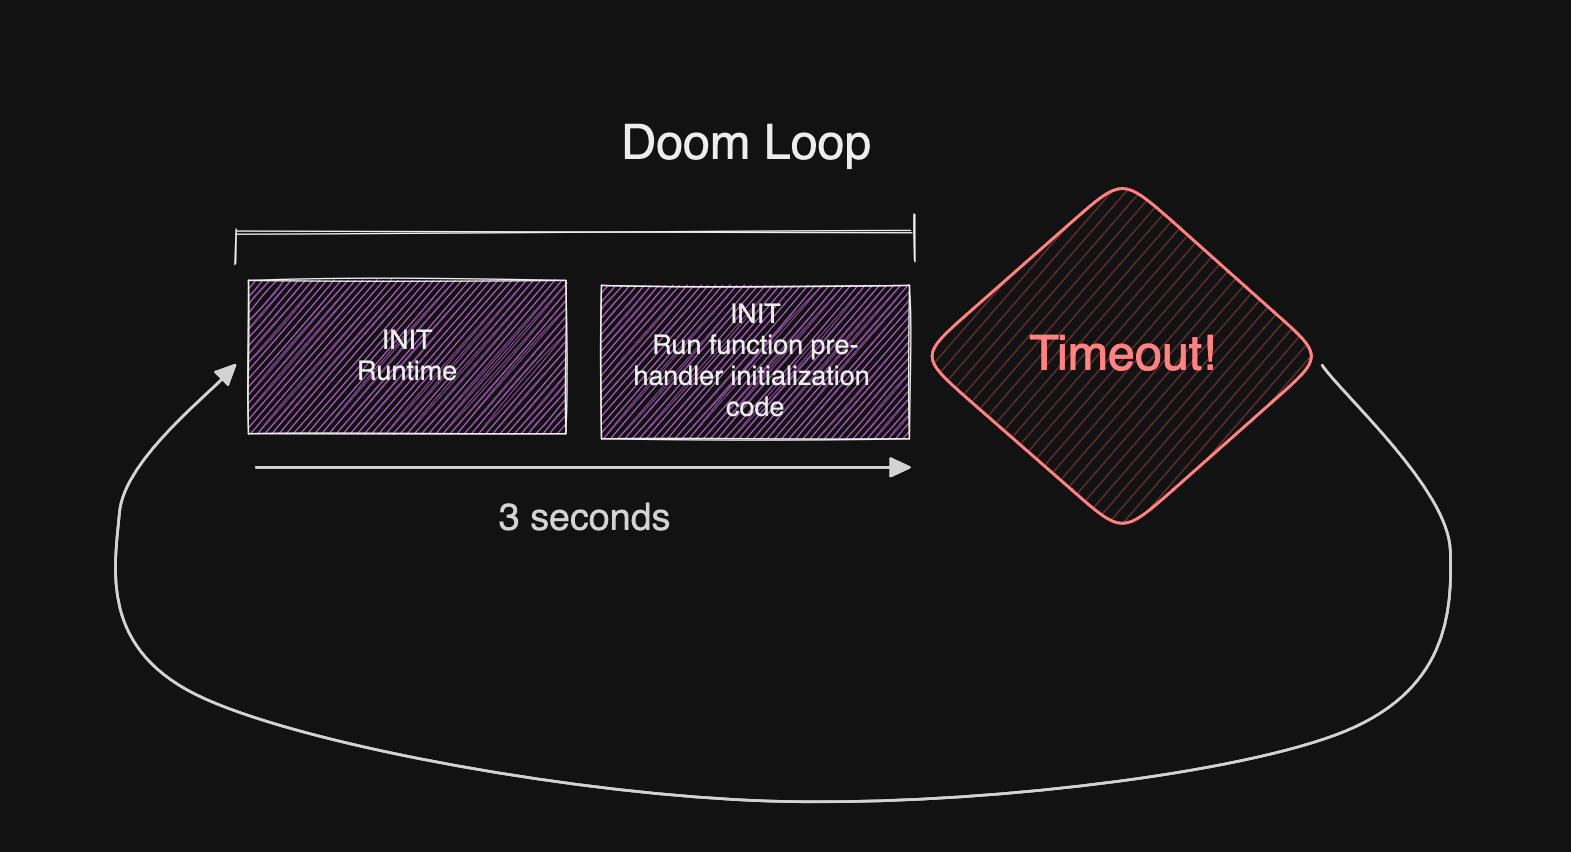
เอกสารภายในของ Microsoft ที่ถูกอ้างในคดีระบุตรงๆ ว่ากลยุทธ์ AI ของบริษัทได้เริ่มวงจรที่ “จะทำร้ายประสิทธิภาพของโมเดลและเว็บทั้งใบไปพร้อมกัน” เพราะมันกำลัง “ทำลายห่วงโซ่อุปทานของตัวเอง” คำพูดนี้เองที่ทำให้สื่อเรียกปรากฏการณ์นี้ว่า “doom loop”
หน้าจอคำตอบที่แทนที่ต้นทาง
AI ดึงข้อมูลจากหลายเว็บไซต์แล้วรวมเป็นคำตอบเดียว พร้อมแสดงแหล่งอ้างอิงไว้ด้านข้าง คนอ่านจึงอาจได้ข้อมูลครบโดยไม่ต้องคลิกเข้าเว็บต้นทาง
จุดสำคัญคือเส้นทางทราฟฟิกที่หายไป เว็บไซต์ยังสร้างเนื้อหา แต่ผู้ใช้ไม่ได้กลับไปอ่านหน้าเดิม เมื่อการเข้าชมลดลง แรงสนับสนุนต่อแหล่งข่าวก็ลดลงตาม และนี่คือภาพของ “doom loop” ที่เอกสารของ Microsoft เองก็ยอมรับ
เมื่อเว็บที่เราใช้หาคำตอบเริ่มไม่มีเหตุผลให้สร้างเนื้อหา
คนทำงานถาม AI แล้วได้คำตอบทันที จึงอาจไม่คลิกอ่านบทความต้นฉบับอีกต่อไป ความสะดวกนี้ทำให้นักข่าว นักรีวิว และนักพัฒนาต้องเสียโอกาสให้คนเห็นผลงาน แม้เนื้อหาของพวกเขายังถูกนำไปใช้ตอบคำถามอยู่ก็ตาม Nick Turley หัวหน้าฝ่าย ChatGPT ของ OpenAI เคยเขียนไว้ในเอกสารที่อ้างในคดีว่าผู้ใช้ “ไม่มีเหตุผลดีๆ ที่จะคลิก” ลิงก์ต้นทางอีกต่อไปเมื่อได้คำตอบจาก AI แล้ว
เจ้าของเว็บไซต์ก็เจอปัญหาเดียวกัน ทราฟฟิกลดลง แต่ต้นทุนการค้นคว้า ตรวจสอบ และดูแลเนื้อหายังอยู่ครบ หากไม่มีคนเข้ามาอ่านหรือสนับสนุน เว็บก็เริ่มมีเหตุผลน้อยลงที่จะสร้างเนื้อหาใหม่ สุดท้าย AI อาจกำลังเร่งวงจรที่ทำให้แหล่งข้อมูลบนเว็บบางลงเรื่อยๆ
คำให้การที่ยืนยันว่าทั้งสองบริษัทรู้ตัวมาตลอด
เอกสารที่ถูกเปิดในคดี New York Times v. OpenAI และ Microsoft ไม่ได้มีแค่คำเตือนภายในเรื่อง doom loop เท่านั้น Brent Hecht ผู้อำนวยการฝ่าย Applied Science ของ Microsoft เคยเรียกการดึงข้อมูลมาเทรนโมเดลว่าเป็น “การขโมยแรงงานครั้งใหญ่ที่สุดในประวัติศาสตร์มนุษย์” และมองว่าการอ้างข้อยกเว้น fair use ของบริษัทเป็น “เรื่องตลกร้ายของแนวคิดเรื่องการใช้งานโดยชอบธรรม”
Satya Nadella ซีอีโอของ Microsoft เองก็ให้การภายใต้คำสาบานว่าแชตบอตทำหน้าที่ “แทนที่” การเข้าเว็บไซต์ของผู้เผยแพร่โดยตรง ขณะที่เอกสารอีกฉบับเผยว่าเมื่อวิศวกรของ OpenAI รายงานว่าหาวิธี “แฮ็กเพื่อเลี่ยงเพย์วอลล์ของ nytimes” ได้ Greg Brockman ผู้ร่วมก่อตั้ง OpenAI ตอบกลับสั้นๆ ว่า “เยี่ยมเลย”
จากเครื่องมือค้นหาสู่คำตอบสำเร็จรูป
| Factor | เว็บแบบเดิม | โมเดล AI รุ่นใหม่ |
|---|---|---|
| วิธีค้นหา | พิมพ์คำค้น แล้วไล่ดูผลลัพธ์ | ถามเป็นภาษาคน แล้วรับคำตอบสรุป |
| แหล่งข้อมูล | เห็นเว็บไซต์ต้นทางชัดเจน | รวมข้อมูลหลายแหล่งเป็นคำตอบเดียว |
| การคลิกออก | ต้องเข้าเว็บไซต์เพื่ออ่านต่อ | จบงานได้ในหน้าคำตอบ |
| ตรวจสอบข้อเท็จจริง | เปิดเทียบแหล่งข่าวได้เอง | ต้องตรวจแหล่งอ้างอิงเพิ่มเติม |
| ผู้ได้ประโยชน์ | ผู้ใช้และเจ้าของเว็บไซต์ | ผู้ใช้และแพลตฟอร์ม AI |
เว็บแบบเดิมพาคนไปหาแหล่งข้อมูล ส่วน AI พยายามย่อเส้นทางให้จบในคำตอบเดียว ความสะดวกจึงเพิ่มขึ้น แต่การมองเห็นและรายได้ของเว็บไซต์ต้นทางอาจลดลงตามไปด้วย
ทราฟฟิกที่หายไปมีตัวเลขจริงเท่าไหร่
ตามเอกสารที่อ้างในคดี บันทึกภายในของ Microsoft ระบุว่าอัตราการคลิกเข้าเว็บไซต์ของ New York Times และ Daily News ลดลงในช่วงประมาณ 80-90% เมื่อผู้ใช้ถามผ่าน Bing Chat หรือ Copilot แทนการค้นหาแบบปกติ
ฝั่งผู้เชี่ยวชาญที่ OpenAI ว่าจ้างก็ประเมินว่าปริมาณทราฟฟิกจากการค้นหาทั่วทั้งเว็บอาจลดลงได้ถึง 60% จากผลของฟีเจอร์สรุปคำตอบอย่าง Google AI Overviews และยังระบุว่าทราฟฟิกจาก Google Discover ลดจากราว 5 พันล้านครั้งต่อเดือนเหลือประมาณ 4 พันล้านครั้ง ส่วนทราฟฟิกจากผลการค้นหาปกติลดจากกว่า 3 พันล้านครั้งเหลือราว 2 พันล้านครั้งต่อเดือน
ใครได้ประโยชน์ เมื่อผู้ใช้ไม่ต้องออกจากแพลตฟอร์ม
| Factor | OpenAI + Microsoft | Google Search | Perplexity |
|---|---|---|---|
| การอ้างอิงแหล่งที่มา | มีลิงก์ตามรูปแบบคำตอบ | แสดงแหล่งข้อมูลหลายรายการ | เน้นลิงก์อ้างอิงในคำตอบ |
| ส่งทราฟฟิกกลับเว็บไซต์ | อาจลดการคลิกออก | ยังเปิดทางให้เลือกเข้าเว็บ | ส่งต่อเมื่อผู้ใช้ต้องการอ่านเพิ่ม |
| ความโปร่งใสของคำตอบ | ขึ้นกับการแสดงที่มา | เห็นผลค้นหาและแหล่งข้อมูล | เห็นที่มาควบคู่คำตอบ |
| การควบคุมโดยผู้เผยแพร่ | ขึ้นกับนโยบายแพลตฟอร์ม | มีเครื่องมือจัดการการค้นหา | ขึ้นกับการเข้าถึงข้อมูล |
| รูปแบบรายได้ | บริการ AI และโฆษณา | โฆษณาจากการค้นหา | บริการสมาชิกและการค้นหา |
ผู้ใช้ได้ความสะดวก แต่แพลตฟอร์มเป็นฝ่ายคุมจุดเริ่มต้นของการอ่านและรายได้มากขึ้น พูดตรงๆ ผู้ได้ประโยชน์ทันทีคือแพลตฟอร์มกับผู้ใช้ ส่วนทางเลือกที่โปร่งใสควรบอกแหล่งที่มา เปิดทางให้เว็บรับทราฟฟิก และให้ผู้เผยแพร่มีสิทธิควบคุมเนื้อหาของตัวเอง
จุดแข็งของคำตอบ AI และสิ่งที่มันกำลังทำให้เว็บเสียไป
ข้อดี
- +ตอบเร็ว ช่วยสรุปเรื่องยากให้เข้าใจง่าย
- +สังเคราะห์ข้อมูลหลายแหล่งเป็นคำตอบเดียว
- +เหมาะกับงานค้นคว้าและระดมไอเดีย
ข้อเสีย
- −อาจตอบผิด แต่ใช้ภาษาที่ดูน่าเชื่อถือ
- −ลดแรงจูงใจให้คนทำเนื้อหาต้นฉบับ
- −อำนาจและรายได้กระจุกอยู่กับแพลตฟอร์มไม่กี่ราย
ความสะดวกนี้มีราคาที่เว็บต้องจ่าย เพราะคนอาจอ่านคำตอบจบโดยไม่เข้าเว็บต้นทาง หากแพลตฟอร์มไม่เปิดเผยที่มาและไม่ส่งคนกลับไปยังผู้เผยแพร่ ระบบนิเวศของเนื้อหาจะค่อยๆ อ่อนแรงลง
ราคาที่ไม่ได้แสดงบนหน้าจอ
ต้นทุนจริงไม่ได้จบที่ค่าบริการหรือค่าโฆษณา เมื่อทราฟฟิกถูกดึงไปอยู่บนแพลตฟอร์ม รายได้ของเว็บต้นทางก็ลดลงตามมา ขณะเดียวกัน ผู้เผยแพร่ยังต้องจ่ายเวลาและแรงงานเพื่อตรวจสอบข้อเท็จจริง แก้ข้อมูลคลาดเคลื่อน และรักษาคุณภาพเนื้อหา
ความเสี่ยงหนักขึ้นเมื่อเว็บไซต์ต้องพึ่งแพลตฟอร์มไม่กี่ราย เพราะการเปลี่ยนนโยบายหรือระบบแนะนำอาจกระทบยอดเข้าชมทันที เว็บขนาดเล็กและแหล่งข้อมูลเฉพาะทางจึงอาจอยู่ยากขึ้น แม้เนื้อหาของพวกเขาจะเป็นวัตถุดิบสำคัญให้ระบบตอบคำถามก็ตาม
คำถามสำคัญอาจไม่ใช่ว่า AI ตอบได้ดีแค่ไหน
อนาคตของ AI บนเว็บไม่ได้วัดแค่ว่าตอบคำถามได้แม่นหรือเร็วเพียงใด แต่ต้องดูด้วยว่ายังทำให้คนอยากผลิต ตรวจสอบ และเผยแพร่ความรู้ต้นฉบับต่อหรือไม่ หากทุกอย่างถูกย่อเป็นคำตอบเดียว แรงจูงใจของคนทำเนื้อหาอาจค่อยๆ หายไป
เอกสารในคดีของ New York Times แสดงให้เห็นว่า OpenAI และ Microsoft รับรู้ปัญหานี้มาตั้งแต่ภายใน แต่ยังคงเดินหน้าธุรกิจในทิศทางเดิม คำถามที่ควรติดตามต่อคือใครควรเป็นคนกำหนดกติกาการแบ่งปันข้อมูล และใครควรได้รับคุณค่าที่เกิดจากข้อมูลเหล่านั้น