โจทย์ Navier-Stokes หนึ่งในเจ็ดปัญหารางวัลมิลเลนเนียมมูลค่า 1 ล้านดอลลาร์ของ Clay Mathematics Institute กลายเป็นชนวนข้อพิพาทระหว่างนักคณิตศาสตร์อิสระกับ OpenAI หลังทีมวิจัยของบริษัทประกาศผลเฉลยตามหลังนักคณิตศาสตร์เพียงหนึ่งวัน
คำถามที่ตามมาไม่ใช่แค่ว่าใครแก้โจทย์ได้ก่อน แต่คือ OpenAI รู้เห็นหรือเข้าถึงแนวทางของนักวิจัยกลุ่มนั้นมากแค่ไหน และมีมาตรฐานความโปร่งใสเรื่องที่มาของข้อมูลฝึกเพียงพอหรือไม่
ข้อพิพาทเริ่มต้นจากใคร และเกี่ยวกับโจทย์อะไร
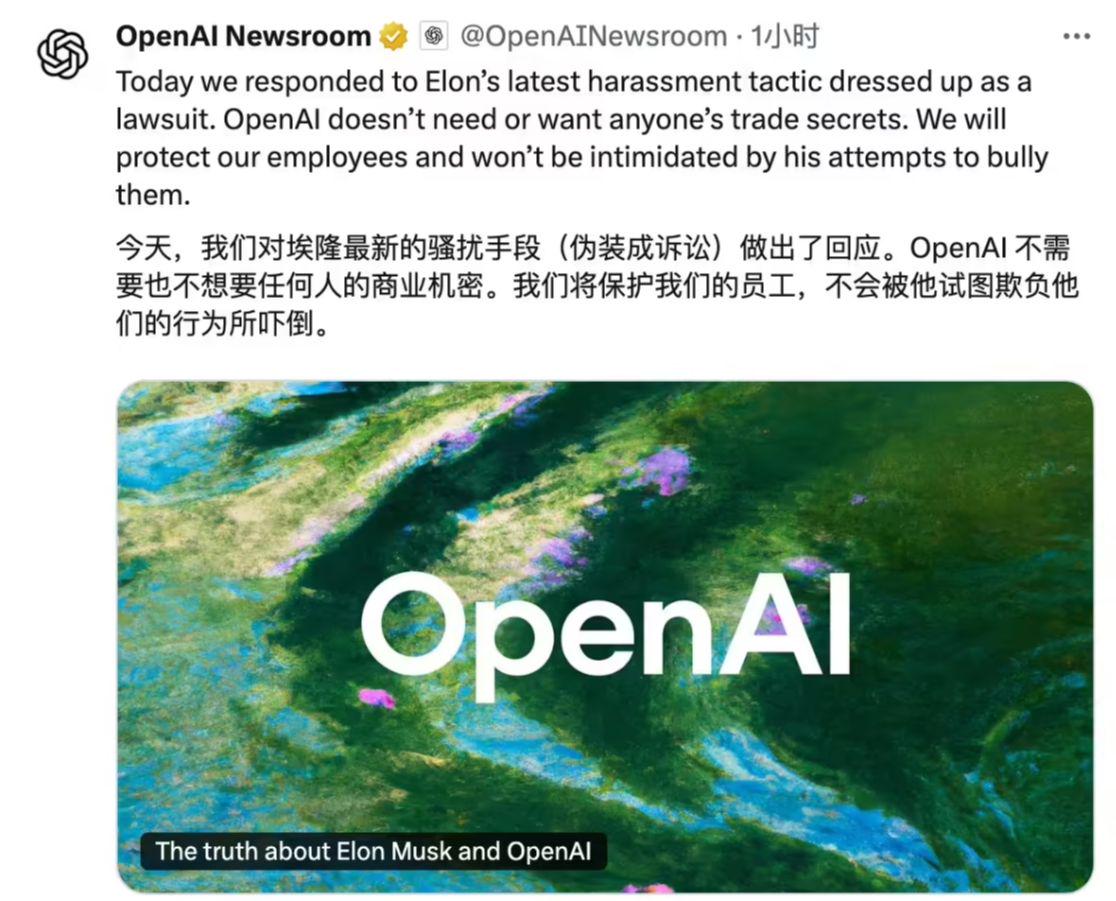
Tristan Buckmaster นักคณิตศาสตร์จาก NYU และ Levent Alpöge ซึ่งทำงานอยู่ที่ Anthropic ร่วมกันพัฒนาแนวทางแก้ปัญหา Navier-Stokes existence and smoothness ด้วยความช่วยเหลือของ AI ตามคำบอกเล่าของ Buckmaster พนักงาน OpenAI เสนอทางเลือกที่เขามองว่ามีปัญหาสองแบบ คือให้เขาโพสต์ผลงานก่อนแล้ว OpenAI ค่อยตามในวันถัดไป หรือร่วมเขียนเปเปอร์ด้วยกันโดยไม่ใส่ชื่อ Alpöge เพราะสังกัด Anthropic ซึ่งเป็นคู่แข่งโดยตรง
สุดท้าย Buckmaster เผยแพร่บทพิสูจน์ฉบับย่อของตัวเองในวันจันทร์ ก่อนที่ OpenAI จะประกาศเฉลยฉบับเต็มในวันถัดมา จังหวะเวลาที่กระชั้นชิดขนาดนี้เองที่ทำให้เกิดคำถามเรื่องที่มาของแนวคิด
เบื้องหลังการแก้โจทย์: โมเดลลับที่ใช้พลังมหาศาล
ตามรายงาน ทีม OpenAI ใช้ทั้งโมเดล Astra ที่เพิ่งเปิดตัวไปก่อนหน้านั้นไม่กี่วัน และโมเดลภายในอีกตัวที่ไม่เปิดเผยชื่อ ซึ่งทำผลงานได้ดีกว่า Astra อย่างชัดเจน โดยรันตัวแทน AI พร้อมกันราวหนึ่งหมื่นชุดในคราวเดียว ด้วยต้นทุนการประมวลผลระดับหลายล้านดอลลาร์
ตัวเลขระดับหมื่นตัวแทนและงบประมวลผลหลักล้านดอลลาร์นี้เองที่ทำให้หลายคนตั้งคำถามว่า ผลลัพธ์ที่ได้มาจากความสามารถของโมเดลล้วนๆ หรือมีการอ้างอิงแนวทางที่มีอยู่แล้วในทางใดทางหนึ่ง
OpenAI ชี้แจงข้อกล่าวหาอย่างไร
Sébastien Bubeck สมาชิกทีมเทคนิคของ OpenAI และ Mark Chen ประธานฝ่ายวิจัยของบริษัท ปฏิเสธว่าตัวแทน AI หรือพนักงานของ OpenAI ไม่ได้เข้าถึงบทสนทนาหรือเอกสารการทำงานของ Buckmaster และ Alpöge แต่อย่างใด
อย่างไรก็ตาม Bubeck ยอมรับว่าทีมได้ยินข่าวลือเกี่ยวกับความพยายามของทั้งสองคนมาก่อน และแรงบันดาลใจส่วนหนึ่งในการเร่งแก้โจทย์นี้ก็มาจากข่าวลือนั้น คำยอมรับนี้เองที่ทำให้เส้นแบ่งระหว่าง “ได้แรงบันดาลใจ” กับ “นำแนวทางไปใช้โดยไม่ให้เครดิต” ยังไม่ชัดเจนสำหรับหลายฝ่าย
เสียงจากนักคณิตศาสตร์อีกคน: คำถามเรื่องข้อมูลฝึกที่มาจาก ChatGPT
นอกจากกรณีของ Buckmaster และ Alpöge แล้ว Andreas Thom นักคณิตศาสตร์อีกคนหนึ่งก็ออกมากล่าวหาว่า OpenAI ปฏิบัติอย่างไม่ซื่อตรงและขาดความโปร่งใสเรื่องที่มาของข้อมูลฝึก โดยเขากังวลว่าบทสนทนาที่ตัวเองและเพื่อนนักวิจัยเคยมีกับ ChatGPT อาจถูกนำไปใช้ประกอบผลลัพธ์ที่ OpenAI นำมาประกาศในภายหลัง
ข้อกล่าวหานี้ต่างจากกรณีแรกตรงที่ไม่ได้พูดถึงเหตุการณ์เดียว แต่พูดถึงรูปแบบการเก็บและใช้ข้อมูลสนทนาของผู้ใช้ในภาพกว้างกว่า ซึ่งเป็นคำถามเชิงนโยบายมากกว่าข้อพิพาทเรื่องเครดิตผลงานชิ้นใดชิ้นหนึ่ง
เทียบมุมมองสองฝั่งให้เห็นภาพชัดขึ้น
| Factor | ฝั่งนักคณิตศาสตร์ | ฝั่ง OpenAI |
|---|---|---|
| สิ่งที่กล่าวหา | ใช้แนวทาง/ข้อมูลของตนโดยไม่ให้เครดิตเต็มที่ | ปฏิเสธการเข้าถึงเอกสารหรือบทสนทนาส่วนตัว |
| จังหวะเวลาที่เป็นข้อโต้แย้ง | โพสต์บทพิสูจน์ก่อน OpenAI หนึ่งวัน | ประกาศเฉลยฉบับเต็มในวันถัดมา |
| คำอธิบายแรงบันดาลใจ | มองว่าใกล้เคียงเกินกว่าจะเป็นเรื่องบังเอิญ | ยอมรับว่าได้ยินข่าวลือเรื่องความพยายามของทีมนักคณิตศาสตร์ |
| ข้อเรียกร้อง | ต้องการหลักฐานตรวจสอบได้เรื่องที่มาของแนวทาง | ยังไม่ได้เปิดเผยกระบวนการตรวจสอบภายในต่อสาธารณะ |
ตารางนี้แสดงให้เห็นว่าทั้งสองฝั่งไม่ได้เห็นตรงกันแม้แต่ในข้อเท็จจริงพื้นฐาน เช่น คำว่า “แรงบันดาลใจ” ที่ OpenAI ใช้ กับคำว่า “ใช้ผลงานโดยไม่ให้เครดิต” ที่ฝั่งนักคณิตศาสตร์มอง จึงยังไม่มีบทสรุปที่ทุกฝ่ายยอมรับร่วมกัน
ผลกระทบต่อวงการคณิตศาสตร์หากความไม่ไว้วางใจนี้ลุกลาม
นักวิจัยจำนวนไม่น้อยกังวลว่าเหตุการณ์นี้จะผลักให้วงการคณิตศาสตร์กลับไปสู่วัฒนธรรมปิดลับมากขึ้น เพราะหากแค่ข่าวลือเรื่องความคืบหน้าของงานวิจัยสามารถจุดชนวนให้บริษัทเทคโนโลยีที่มีทรัพยากรมหาศาลเข้ามาแข่งได้ทันที นักคณิตศาสตร์อิสระก็มีแรงจูงใจน้อยลงที่จะแชร์ความคืบหน้าก่อนงานจะเสร็จสมบูรณ์
ผมว่าความเสี่ยงตรงนี้สำคัญไม่แพ้ข้อพิพาทเรื่องเครดิตเลยครับ เพราะถ้าคนที่ค้นพบสิ่งใหม่ต้องเก็บงานไว้คนเดียวจนกว่าจะพิมพ์เผยแพร่ ความเร็วในการต่อยอดองค์ความรู้ของทั้งวงการก็จะช้าลงไปด้วย
จุดแข็งและความเสี่ยงของการใช้ AI เร่งงานพิสูจน์คณิตศาสตร์
ข้อดี
- +ช่วยไล่ความเป็นไปได้หลายแนวทางพร้อมกันได้เร็วกว่ามนุษย์มาก
- +เปิดโอกาสให้ปัญหาที่ค้างมานานได้รับการทดลองแก้ด้วยมุมมองใหม่
ข้อเสีย
- −ยากที่จะตรวจสอบว่าโมเดลเรียนรู้จากแนวทางของใครมาก่อนหรือไม่
- −อาจบั่นทอนแรงจูงใจให้นักวิจัยอิสระแชร์ความคืบหน้าก่อนงานเสร็จ
คำถามที่ยังไม่มีคำตอบชัดเจนในตอนนี้
ยังไม่มีหลักฐานสาธารณะที่พิสูจน์ได้ว่า OpenAI เข้าถึงเอกสารหรือบทสนทนาของ Buckmaster, Alpöge หรือ Thom โดยตรง สิ่งที่ยืนยันได้ในตอนนี้มีเพียงคำกล่าวหาจากฝั่งนักคณิตศาสตร์ และคำปฏิเสธพร้อมคำยอมรับบางส่วนจากฝั่ง OpenAI เท่านั้น
คำถามที่ OpenAI ยังไม่ได้ตอบต่อสาธารณะคือ กระบวนการตรวจสอบภายในที่ใช้ยืนยันว่าตัวแทน AI ไม่ได้เข้าถึงข้อมูลภายนอกที่ไม่ได้รับอนุญาตนั้นทำงานอย่างไร และบริษัทจะเปิดเผยรายละเอียดนี้ให้นักวิจัยภายนอกตรวจสอบซ้ำได้หรือไม่
บทสรุป: ความไว้วางใจที่วงการคณิตศาสตร์เรียกร้องจาก OpenAI
ข้อพิพาทเรื่องโจทย์ Navier-Stokes สะท้อนปัญหาที่ใหญ่กว่าความขัดแย้งรายกรณี นั่นคือมาตรฐานความโปร่งใสของบริษัท AI เมื่อโมเดลเริ่มแตะปัญหาระดับแนวหน้าของวงการวิชาการ
ตราบใดที่ OpenAI ยังไม่เปิดเผยกระบวนการตรวจสอบที่มาของแนวทางแก้ปัญหาอย่างละเอียดพอให้บุคคลภายนอกตรวจสอบซ้ำได้ ข้อสงสัยจากนักคณิตศาสตร์ก็ยังมีเหตุผลให้คงอยู่ต่อไป และคำถามที่ว่าความก้าวหน้าทางคณิตศาสตร์ของ AI มาจากการเรียนรู้ทั่วไปจริงหรือมาจากการอ้างอิงงานที่มีเจ้าของอยู่แล้วก็จะยังไม่มีคำตอบที่ชัดเจน