AI safety กำลังขยับจากหัวข้อเฉพาะกลุ่มในแล็บวิจัย ไปสู่แวดวงที่มีทั้งบริษัทเทคโนโลยี นักวิจัยอิสระ และเงินลงทุนเข้ามาเกี่ยวข้องมากขึ้นทุกเดือน
จุดที่ทำให้เรื่องนี้ร้อนแรงขึ้นอีกขั้นคือข้อเสนอของ Dario Amodei ซีอีโอ Anthropic ที่อยากให้ผู้ตรวจสอบอิสระเข้าไปอยู่ “ข้างใน” บริษัท AI ชั้นนำ ไม่ใช่แค่ตรวจจากภายนอกเหมือนที่ผ่านมา บทความนี้จะพาไปดูว่าข้อเสนอนี้คืออะไร ใครหนุน ใครยังกังขา และช่องว่างที่เหลืออยู่มีอะไรบ้าง
ข้อเสนอของ Amodei ที่อยากให้คนนอกเข้าไปนั่งในบริษัท
Amodei เสนอให้ฝังผู้ประเมินอิสระไว้ในบริษัท AI แนวหน้าโดยตรง แทนที่จะให้ตรวจสอบเป็นครั้งคราวจากภายนอก ผู้ประเมินกลุ่มนี้จะได้สิทธิ์เข้าถึงระบบของบริษัทในระดับที่ไม่เคยมีมาก่อน เพื่อรายงานเหตุการณ์ด้านความปลอดภัย ประเมินว่าโมเดลสอดคล้องกับเป้าหมายที่ตั้งไว้จริงหรือไม่ และเผยแพร่ผลการตรวจสอบต่อสาธารณะ
Anthropic ประกาศว่าจะให้สิทธิ์การเข้าถึงระดับนี้กับ METR และ Redwood Research ขณะที่ Sam Altman ซีอีโอ OpenAI ก็บอกว่า OpenAI จะทำแบบเดียวกัน นี่คือจุดเปลี่ยนสำคัญ เพราะที่ผ่านมาการตรวจสอบโมเดลจากคนนอกมักถูกจำกัดด้วยเวลาและขอบเขตที่บริษัทเป็นคนกำหนดเอง
METR กับ Redwood Research คือใคร ทำหน้าที่อะไร
METR (Model Evaluation and Threat Research) เป็นองค์กรไม่แสวงกำไรในเมืองเบิร์กลีย์ รัฐแคลิฟอร์เนีย เชี่ยวชาญด้านการประเมินว่าโมเดล AI แนวหน้าทำงานที่ซับซ้อนและต่อเนื่องเป็นระยะเวลานาน (agentic tasks) ได้ดีแค่ไหน และมีความเสี่ยงตรงไหนบ้างเมื่อปล่อยให้ทำงานเองโดยไม่มีคนคอยกำกับ
ส่วน Redwood Research ทำงานร่วมกับหน่วยงานรัฐและให้คำปรึกษาบริษัท AI หลายแห่ง รวมถึง Google DeepMind และ Anthropic ในเรื่องแนวทางประเมินและลดความเสี่ยงจากโมเดลที่ทำงานแบบ agent แล้วเบี่ยงเบนไปจากเป้าหมายที่ตั้งไว้ (misalignment) ทั้งสององค์กรจึงเป็นตัวเลือกที่สมเหตุสมผลสำหรับบทบาทผู้ประเมินอิสระที่ Amodei พูดถึง
ทำไมนักวิจัยอิสระยังไม่กล้าเชื่อทั้งหมด
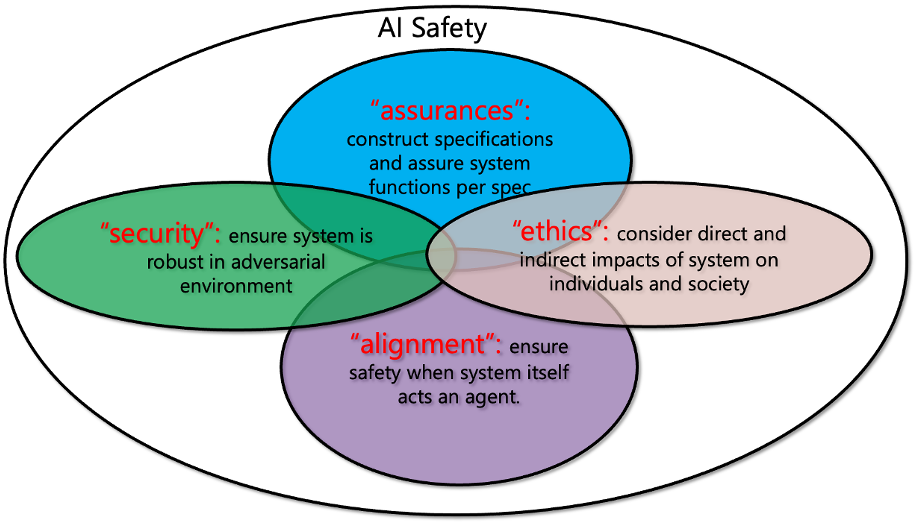
นักวิจัยอิสระในวงการต้อนรับข้อเสนอนี้ แต่ก็ยังตั้งคำถามอยู่ไม่น้อย เพราะประสบการณ์ที่ผ่านมากับบริษัท AI มักมาพร้อมสัญญาห้ามเปิดเผยข้อมูล (NDA) ที่เข้มงวด และหน้าต่างเวลาสำหรับตรวจสอบที่สั้นเกินกว่าจะเห็นปัญหาที่ซ่อนอยู่จริง
สิ่งที่นักวิจัยอิสระต้องการเพิ่มเติมคือสิทธิ์เผยแพร่ผลการตรวจสอบที่รับประกันได้ล่วงหน้า ไม่ใช่ต้องขออนุญาตบริษัทก่อนทุกครั้ง ระยะเวลาเข้าถึงระบบที่ยาวพอจะเห็นพฤติกรรมจริง โอกาสสัมภาษณ์พนักงานภายใน และท้ายที่สุดคือกฎระเบียบที่มีผลผูกพันทางกฎหมาย ไม่ใช่แค่คำมั่นที่บริษัทเลือกทำตามเองได้
| Factor | สิ่งที่บริษัทเสนอในตอนนี้ | สิ่งที่นักวิจัยอิสระเรียกร้อง |
|---|---|---|
| สิทธิ์เผยแพร่ผล | ขึ้นกับดุลยพินิจบริษัท | รับประกันไว้ล่วงหน้าในสัญญา |
| ระยะเวลาตรวจสอบ | จำกัดตามรอบที่บริษัทกำหนด | ยาวพอให้เห็นพฤติกรรมต่อเนื่อง |
| การเข้าถึงคนใน | แทบไม่มีการพูดคุยกับพนักงาน | มีช่องทางสัมภาษณ์ทีมงานจริง |
| สถานะข้อผูกมัด | คำมั่นสมัครใจของบริษัท | กฎระเบียบที่มีผลบังคับใช้ |
ช่องว่างระหว่างสองคอลัมน์นี้คือเหตุผลที่แม้ Anthropic และ OpenAI จะประกาศเปิดทางให้ตรวจสอบ แต่ยังไม่มีใครกล้าฟันธงว่าการตรวจสอบจะเป็นอิสระจริงตามที่พูดไว้
จากเช็กคำตอบอันตราย สู่การตรวจพฤติกรรมทั้งวงจรของโมเดล
งานตรวจสอบความปลอดภัยยุคก่อนเน้นดูว่าโมเดลตอบคำถามอันตรายหรือเปล่าในแต่ละครั้ง แต่งานของ METR และ Redwood Research ที่ Amodei อยากให้เข้าถึงระบบมากขึ้น มุ่งไปที่การดูพฤติกรรมของโมเดลตลอดกระบวนการ ตั้งแต่ตอนถูกกดดัน ถูกหลอกให้ทำนอกขอบเขต ไปจนถึงตอนถูกปล่อยให้ทำงานต่อเนื่องแบบ agent โดยไม่มีคนคอยเช็กทุกขั้นตอน
นี่คือเหตุผลที่ผู้ตรวจสอบอิสระต้องการเวลาที่ยาวขึ้น เพราะพฤติกรรมเสี่ยงบางแบบไม่โผล่ออกมาในการทดสอบครั้งเดียว แต่ค่อยๆ ปรากฏเมื่อโมเดลถูกใช้งานต่อเนื่องในสถานการณ์ที่หลากหลายขึ้น
ต้นทุนที่บริษัทต้องแลกเมื่อเปิดให้คนนอกเข้ามาตรวจ
การให้ผู้ประเมินอิสระเข้าถึงระบบระดับลึกไม่ใช่แค่เรื่องท่าทีที่ดี แต่มีต้นทุนจริงตามมา ทั้งความเสี่ยงที่ข้อมูลภายในหรือรายละเอียดโมเดลจะรั่วไหลระหว่างการตรวจสอบ และความเป็นไปได้ที่ผลตรวจจะกระทบภาพลักษณ์บริษัทหากพบปัญหาที่ยังแก้ไม่เสร็จ
อีกด้านหนึ่งคือกระบวนการตรวจสอบที่ยาวขึ้นอาจทำให้การเปิดตัวโมเดลใหม่ช้าลง ซึ่งเป็นแรงกดดันที่บริษัทต้องชั่งน้ำหนักระหว่างความเร็วในการแข่งขันกับความน่าเชื่อถือของระบบที่ปล่อยออกไป
จุดแข็งของข้อเสนอนี้ กับช่องว่างที่ยังต้องอุด
ข้อเสนอของ Amodei ทำให้การตรวจสอบ AI แนวหน้ามีโอกาสเป็นระบบมากขึ้นกว่าที่ผ่านมา และเปิดทางให้ METR กับ Redwood Research ทำงานได้ลึกกว่าการทดสอบจากภายนอกแบบเดิม
ข้อดี
- +เปิดทางให้ผู้ประเมินอิสระเข้าถึงระบบในระดับที่ไม่เคยมีมาก่อน
- +มีทั้ง Anthropic และ OpenAI ประกาศเข้าร่วมพร้อมกัน
- +ผลักดันให้เกิดมาตรฐานการรายงานเหตุการณ์ด้านความปลอดภัยที่ชัดเจนขึ้น
ข้อเสีย
- −ยังเป็นคำมั่นสมัครใจ ไม่มีผลผูกพันทางกฎหมาย
- −สิทธิ์เผยแพร่ผลตรวจสอบยังไม่ถูกรับประกันไว้ล่วงหน้า
- −ระยะเวลาและขอบเขตการเข้าถึงยังขึ้นอยู่กับบริษัทเป็นหลัก
ใครควรเป็นคนตัดสินว่า AI ปลอดภัยพอหรือยัง
คำถามที่ยังไม่มีคำตอบชัดคือ เมื่อผู้ประเมินอิสระเข้าไปอยู่ในบริษัทแล้ว พวกเขาจะยังคงความเป็นอิสระได้จริงแค่ไหน ในเมื่อค่าใช้จ่ายและการเข้าถึงระบบยังต้องพึ่งพาความร่วมมือจากบริษัทที่ตัวเองกำลังตรวจสอบอยู่
สุดท้ายแล้วคำถามสำคัญจึงไม่ใช่แค่ว่าบริษัทไหนยอมเปิดประตูให้คนนอกเข้ามาตรวจก่อน แต่คือใครจะเป็นคนกำหนดว่าการตรวจสอบแบบไหนถึงเรียกว่าเพียงพอ และใครมีอำนาจบังคับให้ทำตามนั้นจริงเมื่อคำมั่นสมัครใจไม่พอ