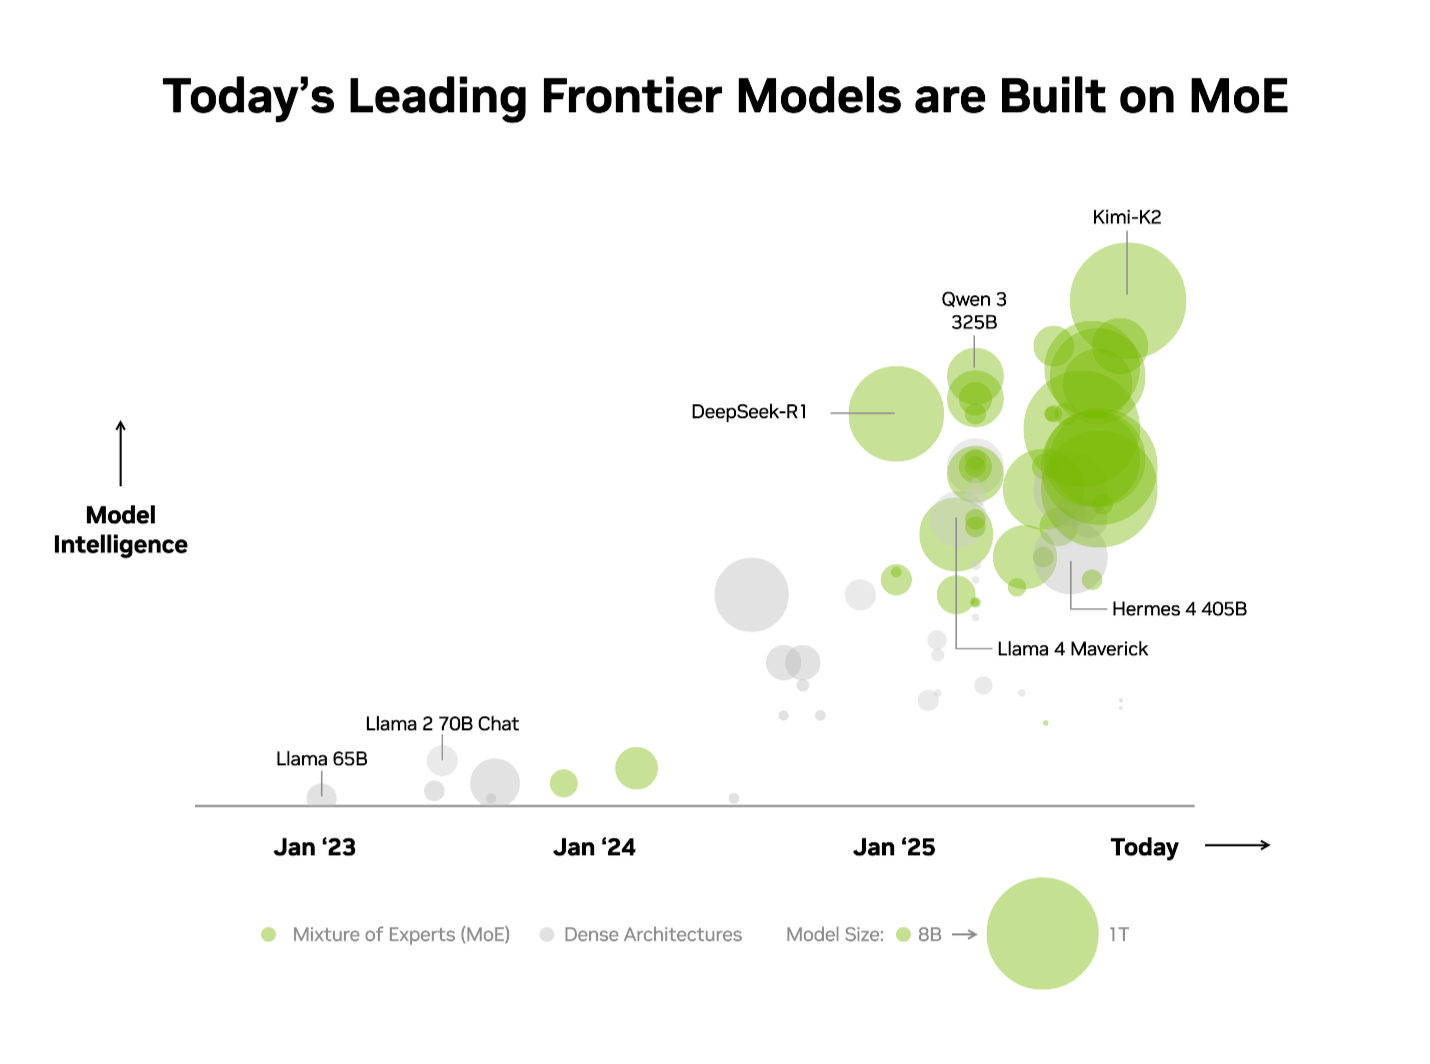
Garry Tan ซีอีโอของ Y Combinator ให้สัมภาษณ์กับ CNBC ว่าถ้าเป็นเรื่องการกำกับดูแลการ “กลั่น” (distill) โมเดล AI เขา “จะไม่ทำอะไรเลย” พร้อมเสนอให้สหรัฐฯ มี “ระบบการกลั่นโมเดลแบบอเมริกัน” ที่เปิดกว้างให้แล็บ AI แบบโอเพนเวทดึงความสามารถจากโมเดลแนวหน้ามาใช้ได้ง่ายขึ้น
จุดยืนนี้สวนทางกับเสียงเรียกร้องจาก Dario Amodei ซีอีโอของ Anthropic ที่อยากให้รัฐบาลสหรัฐฯ เข้มงวดกับการกลั่นโมเดลมากขึ้น หลัง Anthropic เพิ่งเปิดรายงานข่าวกรองภัยคุกคามฉบับที่สอง กล่าวหาว่ากลุ่มแล็บจีนใช้วิธีฉ้อโกงและขโมยข้อมูลรับรองบัญชีเพื่อทำ “การโจมตีด้วยการกลั่นโมเดลแบบผิดกฎหมาย”
สิ่งที่ Garry Tan พูดกับ CNBC จริงๆ
การกลั่นโมเดล คือเทคนิคที่ใช้กันทั่วไปในวงการ AI โดยป้อนคำสั่งจำนวนมากให้โมเดลต้นแบบตอบ แล้วนำคำตอบเหล่านั้นไปฝึกโมเดลใหม่ที่เล็กกว่าให้เลียนแบบวิธีคิดและการให้เหตุผลของต้นแบบ Tan มองว่านี่เป็นเรื่องปกติของการพัฒนา AI ไม่ใช่การกระทำที่ต้องเข้มงวดเป็นพิเศษ จึงไม่เห็นด้วยกับแนวทางที่ Amodei เสนอ
ทำไมเรื่องนี้ถึงร้อนแรงในตอนนี้
รายงานของ Anthropic ระบุว่ากลุ่มที่เชื่อมโยงกับจีนใช้ Claude เพื่อช่วยกลั่นความสามารถจากโมเดลแนวหน้าโดยไม่ได้รับอนุญาต ผ่านการปลอมตัวและใช้บัญชีที่ขโมยมา ซึ่งเป็นเหตุผลที่ Amodei อยากเห็นกติกาที่เข้มงวดขึ้นเพื่อปกป้องทรัพย์สินทางปัญญาของแล็บที่ลงทุนฝึกโมเดลแนวหน้า
แต่ Tan แย้งว่าแล็บเจ้าของโมเดลปิดเองก็ไม่ได้ขออนุญาตเจ้าของลิขสิทธิ์ก่อนนำข้อมูลสาธารณะจำนวนมหาศาลไปฝึกโมเดลตั้งแต่แรก ดังนั้นความรู้ที่ถูกฝึกจากข้อมูลสาธารณะในวงกว้างก็ควรมีสถานะใกล้เคียงสาธารณสมบัติมากกว่าทรัพย์สินที่บริษัทเดียวผูกขาดได้เต็มที่
จุดยืนของ Tan เทียบกับข้อเรียกร้องของ Amodei
| Factor | แนวทางของ Amodei | แนวทางของ Tan |
|---|---|---|
| ท่าทีต่อการกลั่นโมเดล | อยากให้รัฐเข้ามากำกับและจำกัด | อยากให้ปล่อยเสรี ไม่ต้องออกกฎใหม่ |
| เหตุผลหลัก | ป้องกันการขโมยทรัพย์สินทางปัญญาและภัยความมั่นคง | ป้องกันไม่ให้อำนาจ AI กระจุกอยู่กับไม่กี่บริษัท |
| กลุ่มที่กังวล | แล็บที่ลงทุนฝึกโมเดลแนวหน้า | แล็บ open-weight และนักพัฒนารายเล็ก |
พูดตรงๆ ทั้งสองฝ่ายมองปัญหาเดียวกันจากมุมต่างกันเท่านั้นเองนะ ฝั่ง Amodei กังวลว่าการกลั่นแบบไม่มีขอบเขตจะทำให้แล็บที่ลงทุนมหาศาลเสียเปรียบและเสี่ยงต่อความมั่นคง ขณะที่ Tan กังวลว่าการกำกับที่เข้มเกินไปจะทำให้อำนาจ AI กระจุกอยู่กับบริษัทปิดไม่กี่รายจนกลายเป็นสถานการณ์ผูกขาดที่เขาเรียกว่า “doomer scenario”
ผลที่ตามมาถ้าข้อเสนอของ Tan เป็นจริง
ถ้าสหรัฐฯ ไม่ออกกฎมาจำกัดการกลั่นโมเดลตามที่ Tan เสนอ แล็บ open-weight จะดึงความสามารถจากโมเดลแนวหน้าไปสร้างโมเดลขนาดเล็กที่ทีมพัฒนานำไปรันเองได้ง่ายขึ้น ทีมเล็กที่ต้องแบกค่า API รายเดือนก็มีทางเลือกเปลี่ยนไปรันโมเดลบนเซิร์ฟเวอร์ของตัวเองแทน ลดการพึ่งพาผู้ให้บริการรายเดียว
องค์กรที่ต้องเก็บข้อมูลอ่อนไหว เช่น เอกสารภายในหรือข้อมูลลูกค้า จะรันโมเดลแบบออฟไลน์ได้โดยไม่ต้องส่งข้อมูลออกนอกระบบ ส่วนนักวิจัยก็ปรับแต่งโมเดลให้เข้ากับภาษาและอุตสาหกรรมเฉพาะทางได้ลึกกว่าการพึ่งพา API เพียงอย่างเดียว
สามแนวทางที่รัฐบาลสหรัฐฯ เลือกได้
การตัดสินใจไม่ได้มีแค่ “ห้าม” หรือ “ปล่อยเสรี” แต่ต้องชั่งน้ำหนักระหว่างการแข่งขัน ความมั่นคง และสิทธิของแล็บเจ้าของโมเดล
| Factor | ห้ามหรือจำกัด (แนว Amodei) | ปล่อยเสรี (แนว Tan) | อนุญาตแบบมีเงื่อนไข |
|---|---|---|---|
| เป้าหมาย | ปกป้องทรัพย์สินทางปัญญาและความมั่นคง | เร่งการแข่งขันและกันการผูกขาด | รักษาสมดุลระหว่างสองด้าน |
| จุดเด่น | ลดความเสี่ยงจากการขโมยข้อมูลรับรองบัญชี | เปิดทางให้แล็บ open-weight ไล่ตามทัน | แยกงานวิจัยออกจากการใช้ในเชิงพาณิชย์ |
| ข้อจำกัด | อาจทำให้แล็บ open-weight พัฒนาช้าลง | เสี่ยงให้กลุ่มที่ไม่หวังดีอ้างเป็นข้ออ้างทำผิด | ต้องมีกลไกตรวจสอบที่ซับซ้อนขึ้น |
ข้อดีข้อเสียของการปล่อยให้กลั่นโมเดลได้เสรี
ข้อดี
- +ลดการผูกขาด AI ในมือแล็บปิดไม่กี่ราย
- +ทีมเล็กเข้าถึงโมเดลความสามารถสูงได้ในราคาถูกลง
- +เปิดทางให้นักวิจัยตรวจสอบและปรับแต่งโมเดลได้มากขึ้น
ข้อเสีย
- −เปิดช่องให้กลุ่มไม่หวังดีอ้างเป็นข้ออ้างขโมยความรู้
- −แล็บเจ้าของโมเดลแนวหน้าอาจเสียแรงจูงใจในการลงทุนวิจัยต่อ
- −ความปลอดภัยและอคติจากต้นแบบตรวจสอบได้ยากขึ้นเมื่อกระจายไปหลายโมเดล
ต้นทุนที่ไม่ได้อยู่แค่หน้าใบเสร็จ
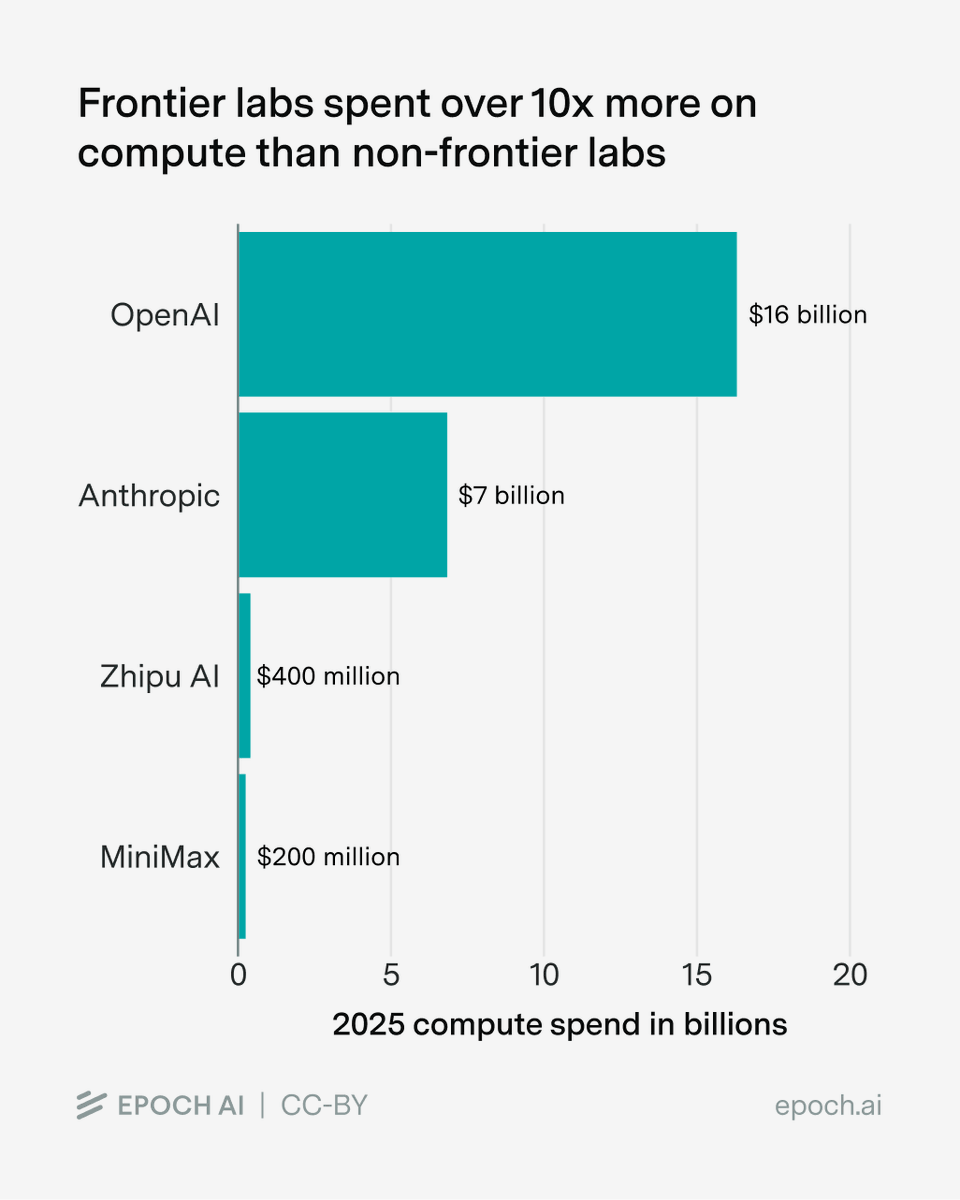
โมเดลที่กลั่นออกมาถูกกว่าโมเดลต้นแบบก็จริง แต่ต้นทุนไม่ได้หายไปไหน ยังมีค่า GPU ค่าไฟ ค่าโฮสติ้ง และค่าแรงทีมที่ต้องดูแลโมเดลหลังเปิดใช้งาน หากข้อมูลที่ใช้ฝึกไม่โปร่งใส ทีมที่นำโมเดลไปใช้ต่อก็อาจต้องแบกความเสี่ยงด้านลิขสิทธิ์และคดีความตามมาด้วย
ที่สำคัญกว่านั้น ถ้าแล็บเจ้าของโมเดลแนวหน้ารู้สึกว่าลงทุนไปแล้วถูกกลั่นเอาความรู้ไปฟรีๆ โดยไม่มีกติกาอะไรกำกับเลย แรงจูงใจในการทุ่มทุนวิจัยรุ่นถัดไปก็อาจลดลงตามไปด้วย ซึ่งสุดท้ายกระทบทุกฝ่ายในระบบนิเวศ AI
คำถามที่ยังไม่มีคำตอบชัดเจน
ข้อเสนอของ Tan ตอบโจทย์เรื่องการกระจายอำนาจ AI และลดต้นทุนให้ทีมเล็ก แต่ยังไม่ได้ตอบว่าจะแยกการกลั่นโมเดลที่ถูกกฎหมายออกจากการโจมตีแบบที่ Anthropic กล่าวหากลุ่มจีนได้อย่างไร ขณะที่ข้อเรียกร้องของ Amodei ก็ยังไม่ชัดว่ากฎที่เข้มงวดขึ้นจะร่างขอบเขตอย่างไรโดยไม่ทำร้ายแล็บ open-weight ที่ทำถูกกฎหมายไปด้วย
สุดท้ายแล้วสิ่งที่รัฐบาลสหรัฐฯ ตัดสินใจจะกำหนดทิศทางว่าใครได้ประโยชน์จากยุคของการกลั่นโมเดลครับ ระหว่างแล็บปิดไม่กี่รายที่กุมโมเดลแนวหน้าไว้ กับระบบนิเวศแบบเปิดที่มีผู้เล่นหลากหลายกว่า และคำตอบนี้จะส่งผลถึงทั้งนักพัฒนา สตาร์ตอัป และผู้ใช้งานทั่วไปในที่สุด