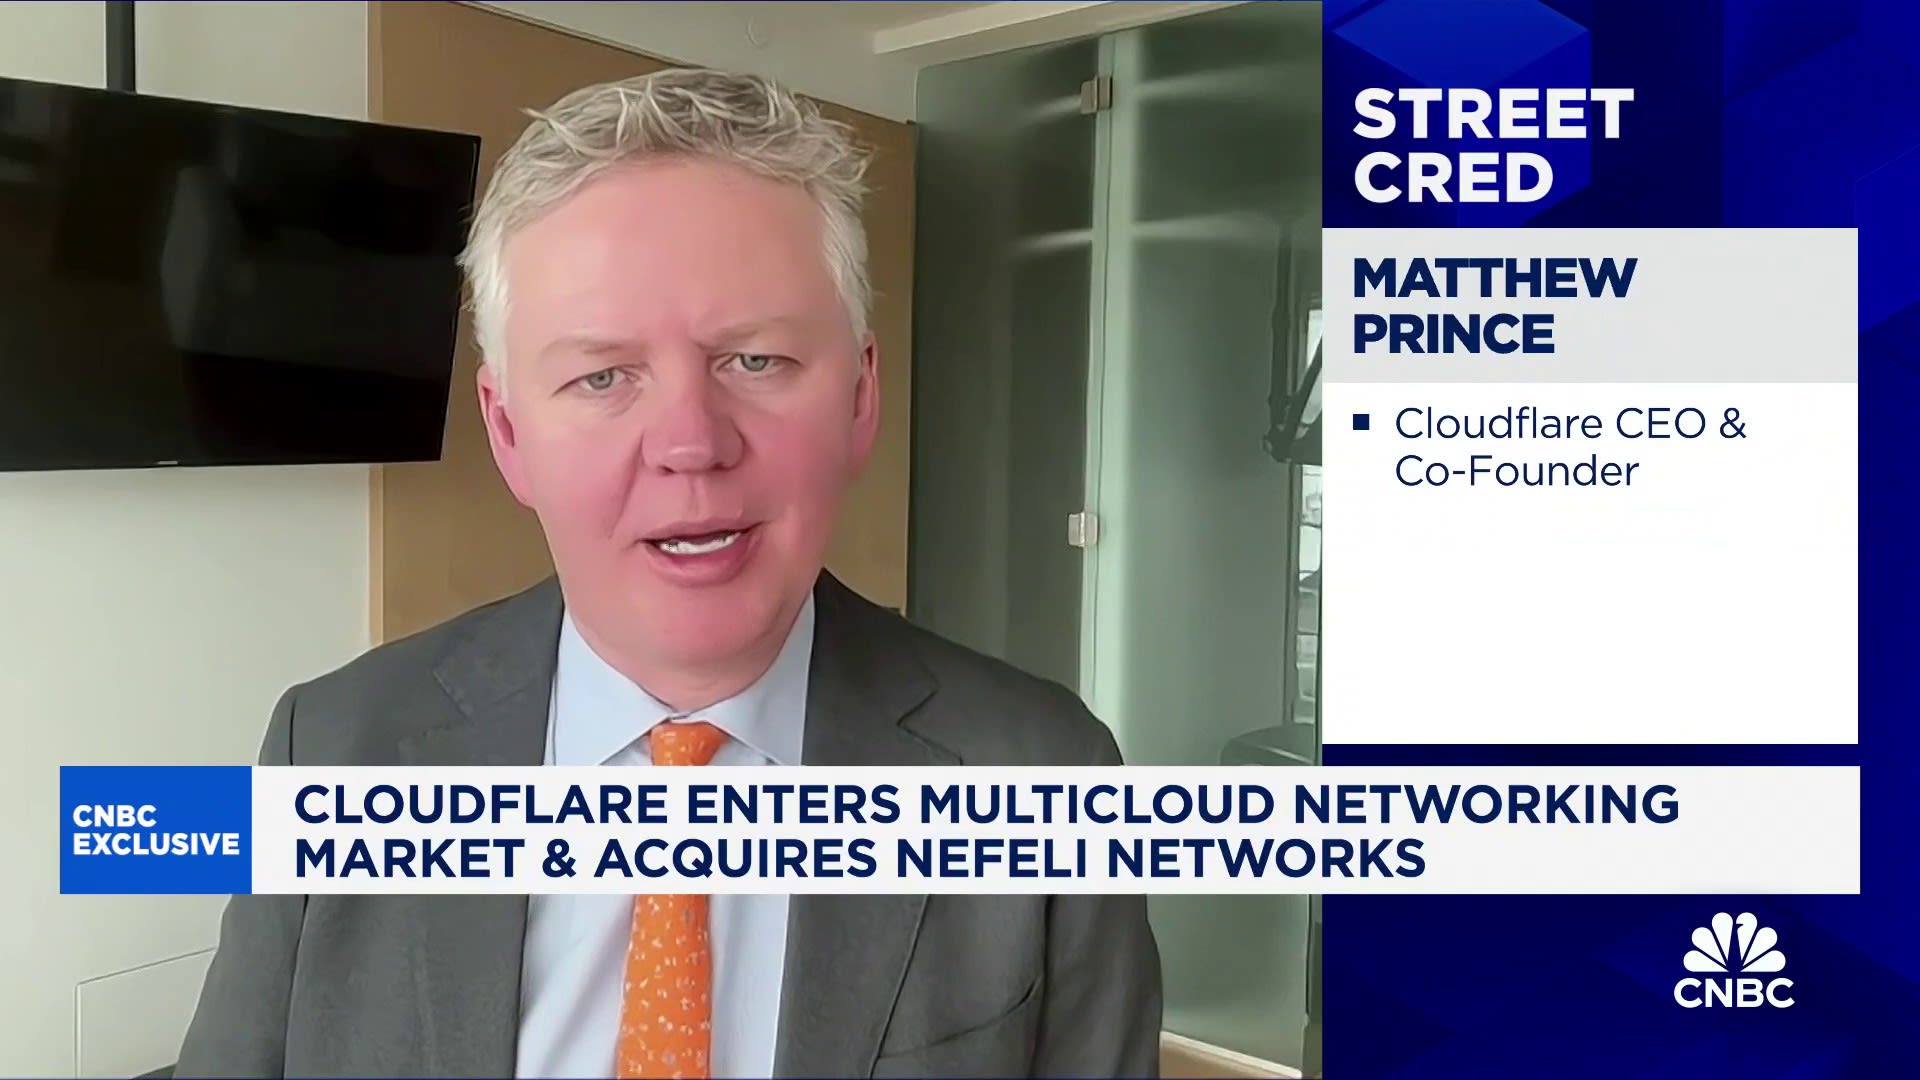
Matthew Prince ซีอีโอ Cloudflare พูดชัดในพอดแคสต์ Decoder ของ The Verge ว่าอนาคตของเว็บกำลังเดินไปทาง “pay to crawl” เพราะบอตและ AI agent กลายเป็นผู้ใช้งานอินเทอร์เน็ตกลุ่มใหญ่ที่สุดไปแล้ว
บทความนี้จะวิเคราะห์ว่าแนวคิดของ Prince ทำงานอย่างไรจริงๆ ตั้งแต่การบล็อกบอตฝึกโมเดล การรื้อโค้ด HTTP ที่ถูกลืมมาหลายสิบปีขึ้นมาใช้ใหม่ ไปจนถึงคำถามว่าเจ้าของเว็บจะได้ประโยชน์จริงแค่ไหน
ประเด็นสำคัญคือ Cloudflare มีตำแหน่งและอิทธิพลมากพอจะผลักดันแนวคิดนี้ให้เกิดขึ้นจริง แต่การนำไปใช้จริงยังไปได้ช้ากว่าที่ตั้งเป้าไว้มาก
เมื่อบอตกลายเป็นผู้ใช้เว็บกลุ่มใหญ่ที่สุด
Prince เคยคาดการณ์ว่าทราฟฟิกจากบอตจะแซงหน้ามนุษย์ราวปลายปี 2027 แต่ตัวเลขจริงกลับมาถึงจุดนั้นเร็วกว่าที่คิดไว้มาก ข้อมูลของ Cloudflare ชี้ว่าบอตคิดเป็นสัดส่วนราว 57.4% ของคำขอ HTTP ทั่วโลก ขณะที่มนุษย์เหลือแค่ 42.6%
Prince บอกว่าคำว่า “bot” “crawler” และ “agent” ตอนนี้แทบเป็นคำเดียวกัน เพราะ AI agent ที่ทำงานแทนผู้ใช้ก็เข้าเว็บไซต์แบบเดียวกับ crawler ที่เก็บข้อมูลไปฝึกโมเดล ความเร็วของการเปลี่ยนแปลงนี้เองที่ทำให้ Cloudflare ต้องรีบหาวิธีรับมือ
Cloudflare อยู่ตรงจุดไหนของโครงสร้างเว็บ
จุดที่ทำให้ Prince มีน้ำหนักในเรื่องนี้คือ Cloudflare อยู่หน้าเว็บไซต์มากกว่าหนึ่งในห้าของเว็บทั้งหมด นั่นหมายความว่าคำขอจาก AI บอตส่วนใหญ่ต้องผ่านโครงสร้างพื้นฐานของ Cloudflare ก่อนถึงเซิร์ฟเวอร์จริงของเจ้าของเว็บ
ตำแหน่งนี้ทำให้ Cloudflare มองเห็นทั้งพฤติกรรมของบอตและความต้องการของเจ้าของเว็บพร้อมกัน จึงกลายเป็นจุดต่อรองตามธรรมชาติระหว่างสองฝั่งที่ปกติไม่เคยคุยกันตรงๆ
แนวคิด “pay to crawl” เบื้องหลังคำพูดของ Prince
หัวใจของแผน Prince มีสองส่วน ส่วนแรกคือบล็อกบอตที่มาเก็บข้อมูลไปฝึกโมเดลเป็นค่าเริ่มต้น รวมถึงบอตของ Google เองด้วย หากไม่ยอมแยกการเก็บข้อมูลเพื่อค้นหาออกจากการเก็บข้อมูลเพื่อฝึกโมเดล
ส่วนที่สองคือการรื้อ HTTP status code 402 ที่ถูกทิ้งไว้เฉยๆ มาหลายสิบปีกลับมาใช้ ให้บอตต้องจ่ายเงินเศษเสี้ยวของหนึ่งเซนต์ต่อการอ่านหนึ่งหน้า แล้ว Cloudflare ค่อยรวบรวมเงินก้อนนั้นแบ่งคืนให้เจ้าของเว็บ คล้ายวิธีที่ Spotify รวมค่าสมาชิกแล้วจ่ายส่วนแบ่งให้ศิลปินตามยอดฟัง
| Factor | แนวทางเดิม | pay to crawl |
|---|---|---|
| การเข้าถึงเนื้อหา | บอตอ่านได้แทบไม่มีเงื่อนไข | ต้องจ่ายผ่าน HTTP 402 ก่อนอ่าน |
| บอตฝึกโมเดล | ปะปนกับบอตค้นหา | บล็อกเป็นค่าเริ่มต้น เว้นแต่แยกชัดเจน |
| รายได้กลับสู่เจ้าของเว็บ | แทบไม่มี | รวมเงินแล้วแบ่งคืนแบบเดียวกับ Spotify |
เปิดตลาดให้เว็บเรียกเก็บเงินจากบอต AI แล้ว แต่คนใช้ยังน้อย
Cloudflare เปิดตัวระบบให้เจ้าของเว็บกั้นบอต AI และเรียกเก็บค่าเข้าถึงมาตั้งแต่ช่วงกลางปี 2025 แต่จนถึงตอนนี้ยังมีเว็บที่เปิดใช้งานจริงจำนวนน้อย ทีมงานยังต้องพัฒนาโปรโตคอลและโครงสร้างรองรับปริมาณคำขอที่เพิ่มขึ้นต่อเนื่อง
ช่องว่างระหว่างแนวคิดกับการใช้งานจริงตรงนี้สำคัญ เพราะบอกว่าแม้ Cloudflare จะมีเครื่องมือพร้อม แต่การเปลี่ยนพฤติกรรมของทั้งเจ้าของเว็บและบริษัท AI ให้มาใช้ระบบเดียวกันยังต้องใช้เวลาอีกมาก
ทางเลือกอื่นในตลาดแก้ปัญหาเดียวกันด้วยวิธีต่างกัน
Cloudflare เลือกยืนอยู่ฝั่งโครงสร้างพื้นฐานและควบคุมการเข้าถึงจากต้นทาง ขณะที่ Google, OpenAI และ Perplexity อยู่ใกล้ประสบการณ์ค้นหาและคำตอบมากกว่า จึงแก้ปัญหาด้วยแนวทางที่ต่างออกไป
| Factor | Cloudflare | OpenAI | Perplexity | |
|---|---|---|---|---|
| จุดเน้น | ควบคุมบอตจากโครงสร้างเว็บ | ค้นหาและจัดอันดับผลลัพธ์ | สร้างคำตอบจากโมเดลและข้อมูลที่ดึงมา | ค้นหาแบบสรุปคำตอบพร้อมอ้างอิง |
| ความสัมพันธ์กับผู้เผยแพร่ | ให้เจ้าของเว็บตั้งกติกาเอง | พึ่งพาเว็บไซต์เพื่อขับเคลื่อนผลค้นหา | ต้องเจรจาสิทธิ์การใช้ข้อมูล | อ้างอิงแหล่งที่มาในคำตอบ |
จุดต่างสำคัญคือ Cloudflare ไม่ได้แข่งด้วยการตอบคำถามเหมือนอีกสามราย แต่พยายามทำให้เจ้าของเว็บมีอำนาจต่อรองมากขึ้นก่อนที่ข้อมูลจะถูกดึงไปใช้เลย
จุดแข็งของแผน Prince และรอยร้าวที่ยังต้องแก้
ข้อดี
- +อยู่หน้าเว็บกว่าหนึ่งในห้าของอินเทอร์เน็ต จึงมีอำนาจต่อรองจริง
- +รื้อมาตรฐาน HTTP 402 ที่มีอยู่แล้วมาใช้ แทนที่จะสร้างระบบใหม่ทั้งหมด
- +วางตัวเป็นกลาง ให้เจ้าของเว็บเป็นคนตัดสินใจเอง
ข้อเสีย
- −อัตราการใช้งานจริงยังต่ำมากตั้งแต่เปิดตัวมากว่าปี
- −ต้องอาศัยความร่วมมือจาก Google และบริษัท AI รายใหญ่ ซึ่งยังไม่ชัดเจน
- −เว็บขนาดเล็กอาจไม่มีคนหรือเวลาตั้งค่าให้ถูกต้อง
ต้นทุนที่เว็บต้องแบกรับแม้ไม่ได้จ่ายเงินให้ Cloudflare เพิ่ม
การใช้ระบบนี้ไม่ได้ฟรีสำหรับเจ้าของเว็บ เพราะต้องตั้งนโยบายแยกบอตค้นหา บอตฝึกโมเดล และบอตที่แค่มาสร้างภาระเซิร์ฟเวอร์ ทีมเล็กอาจไม่มีกำลังคนพอจะตามอัปเดตกฎทุกครั้งที่บริษัท AI เปลี่ยนวิธีเก็บข้อมูล
อีกความเสี่ยงคือทราฟฟิกค้นหาที่อาจลดลงต่อเนื่อง เพราะผู้ใช้ได้คำตอบจาก AI โดยไม่ต้องคลิกเข้าเว็บต้นทาง ต่อให้เจ้าของเว็บเรียกเก็บเงินจากบอตได้จริง รายได้จากโฆษณาและยอดผู้เข้าชมที่หายไปก็ยังเป็นโจทย์แยกต่างหาก
สุดท้ายแล้ว Cloudflare กอบกู้เว็บเปิดได้จริงไหม
ตอนนี้ Cloudflare มีทั้งตำแหน่ง เครื่องมือ และมาตรฐานทางเทคนิคพร้อมใช้งาน แต่ตัวเลขอัตราการใช้งานที่ยังต่ำบอกว่าแผนนี้ยังไม่ใช่ความสำเร็จที่เกิดขึ้นจริงในวันนี้ครับ สิ่งที่จะตัดสินผลลัพธ์จริงๆ คือ Google และบริษัท AI รายใหญ่จะยอมเล่นตามกติกาเดียวกันหรือไม่
ถ้าไม่มีใครยอมขยับ เว็บก็อาจเปลี่ยนจากที่เปิดให้ทุกคนเข้าถึง กลายเป็นเว็บที่ต้องผ่านด่านของใครสักคน ไม่ว่าจะเป็น Cloudflare เอง หรือบริษัท AI ที่ยังคุมช่องทางระหว่างเนื้อหากับผู้ชมอยู่ดี