Voxtral 3 คือชุดโมเดลเสียงและ Voice Agent SDK สำหรับการสนทนาแบบเรียลไทม์ รองรับมากกว่า 50 ภาษา และรวมการฟัง การคิด การพูด รวมถึงการเรียกใช้เครื่องมือไว้ในกระบวนการเดียว
จึงเหมาะกับงานที่ต้องทำหลายขั้นตอนระหว่างคุย เช่น ดึงข้อมูล ติดต่อระบบธุรกิจ หรือทำงานผ่านโทรศัพท์และเว็บ องค์กรเลือกใช้ API ที่โฮสต์ในสหภาพยุโรป หรือ deploy บนโครงสร้างพื้นฐานของตัวเองเพื่อควบคุมการจัดการข้อมูลได้
ภาพรวมของ Voxtral 3
Voxtral 3 เป็นชุดโมเดลเสียงและ voice agent SDK สำหรับสร้างระบบสนทนาแบบเรียลไทม์ โดยมีทั้ง speech-to-text และ text-to-speech ในตระกูลเดียวกัน
จุดเด่นคือรองรับการแยกผู้พูด ตรวจจับจังหวะจบการพูด และปรับอารมณ์ น้ำหนักเสียง รวมถึงจังหวะการพูดตามบริบท จึงเหมาะกับ contact center, virtual assistant และ hands-free copilot ที่ต้องคุยกับผู้ใช้แบบเป็นธรรมชาติครับ
เมื่อการแปลเสียงต้องนำไปสู่การลงมือทำ
ลองนึกภาพผู้ใช้มีจดหมายส่งต่อแพทย์ผิวหนังเป็นภาษาฝรั่งเศส ระบบต้องอ่านและเข้าใจว่าเป็นการส่งพบ Dr Martin จากนั้นนัดคิววันอังคารเวลา 5:45 pm พร้อมส่งรายละเอียดเป็นภาษาอังกฤษ
นี่คือโจทย์จริงของ Voice Agent เพราะการแปลอย่างเดียวไม่พอ ระบบต้องฟังให้ถูก จับความหมายตามบริบท คุยตอบอย่างเป็นธรรมชาติ และเรียกใช้ระบบนัดหมายต่อหลายขั้นตอนในบทสนทนาเดียวกัน หากขาดขั้นใดขั้นหนึ่ง ผู้ใช้ก็ยังต้องทำงานต่อเองอยู่ดี
Voxtral 3 อยู่ตรงไหนในตระกูลโมเดลของ Mistral
Voxtral 3 ไม่ใช่โมเดลเดียว แต่เป็นครอบครัวโมเดลเสียงรุ่นใหม่ของ Mistral ประกอบด้วยโมเดลถอดเสียง โมเดลสร้างเสียง และ Voice Agent SDK ที่รวมการฟัง การคิด การเรียกใช้เครื่องมือ และการพูดไว้ในกระบวนการเดียว
ด้านการใช้งาน องค์กรเลือกเชื่อมต่อผ่าน EU-hosted API ของ Mistral หรือ ติดตั้งบนโครงสร้างพื้นฐานของตัวเองได้ แบบหลังช่วยควบคุมได้ว่าเสียงจะถูกประมวลผลที่ไหน ข้อมูลถูกจัดการอย่างไร และจะเก็บบทสนทนาไว้หรือไม่
จาก Voxtral Mini Transcribe 2 สู่ตระกูล Voxtral 3
กราฟ Concatenated Minimum Permutation WER ระบุว่า Voxtral Small Transcribe 3 อยู่ที่ 18.4% และ Voxtral Mini Transcribe 3 อยู่ที่ 18.6% ขณะที่ Voxtral Mini Transcribe 2 อยู่ที่ 30.9% โดยค่ายิ่งต่ำยิ่งดี
ข้อมูลของ Voxtral Mini Transcribe 2 ในแหล่งข้อมูลมีจำกัด จึงไม่ควรสรุปความแตกต่างด้านคุณสมบัตินอกเหนือจากผลทดสอบนี้
| Factor | Voxtral Mini Transcribe 2 | Voxtral Small Transcribe 3 |
|---|---|---|
| Concatenated Minimum Permutation WER | 30.9% | 18.4% |
| ผลทดสอบ | กราฟระบุผลทดสอบ | กราฟระบุผลทดสอบ |
ฟีเจอร์เหล่านี้ทำงานอย่างไรเมื่อเจอสถานการณ์จริง
อ่านบทสนทนาหลายภาษาและแยกผู้พูด
ในสายบริการที่หลายคนพูดแทรกกัน Voxtral Transcribe 3 รองรับมากกว่า 50 ภาษา และแยกได้ว่าใครพูดอะไร ช่วยให้ตามบทสนทนาได้แม่นขึ้น ส่วน keyphrases ช่วยให้ระบบจับคำศัพท์เฉพาะทางได้ดีขึ้น โดยไม่ต้อง fine-tuning
รู้จังหวะที่ผู้พูดพูดจบ
end-of-turn detection ช่วยให้เอเจนต์รู้ว่าคู่สนทนาพูดจบแล้ว จึงตอบกลับได้ทันจังหวะ เหมาะกับศูนย์บริการและผู้ช่วยผ่านโทรศัพท์ที่ต้องคุยแบบสด
ปรับน้ำเสียงตามบริบทของการสนทนา
Voxtral Mini TTS 3 ปรับอารมณ์ จังหวะ และการเน้นเสียงตามบริบท รองรับมากกว่า 35 ภาษาและ 50 สำเนียง ทำให้เสียงตอบกลับเป็นธรรมชาติมากขึ้น
ฟัง คิด เรียกใช้เครื่องมือ และทำงานต่อเนื่อง
Voice agent SDK รวมการฟัง คิด เรียกใช้เครื่องมือ และพูดไว้ใน pipeline เดียว เอเจนต์จึงดึงข้อมูล ติดต่อระบบธุรกิจ และทำงานหลายขั้นตอนต่อเนื่องระหว่างคุยผ่านโทรศัพท์หรือเว็บไซต์ได้
เทียบผลถอดเสียงกับทางเลือกอื่น
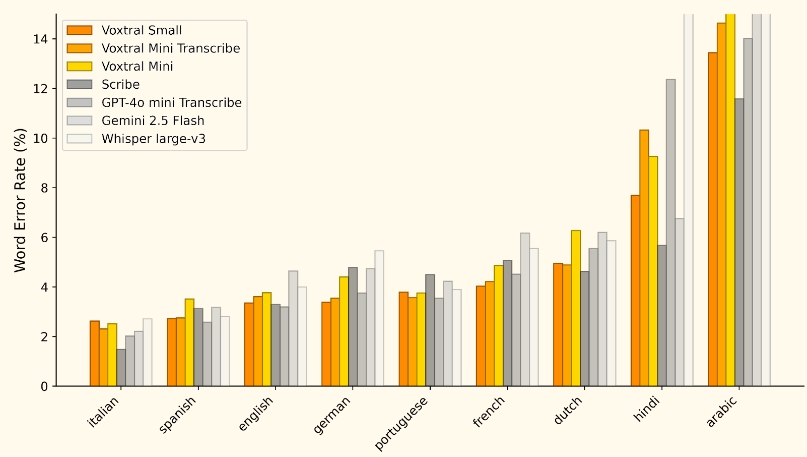
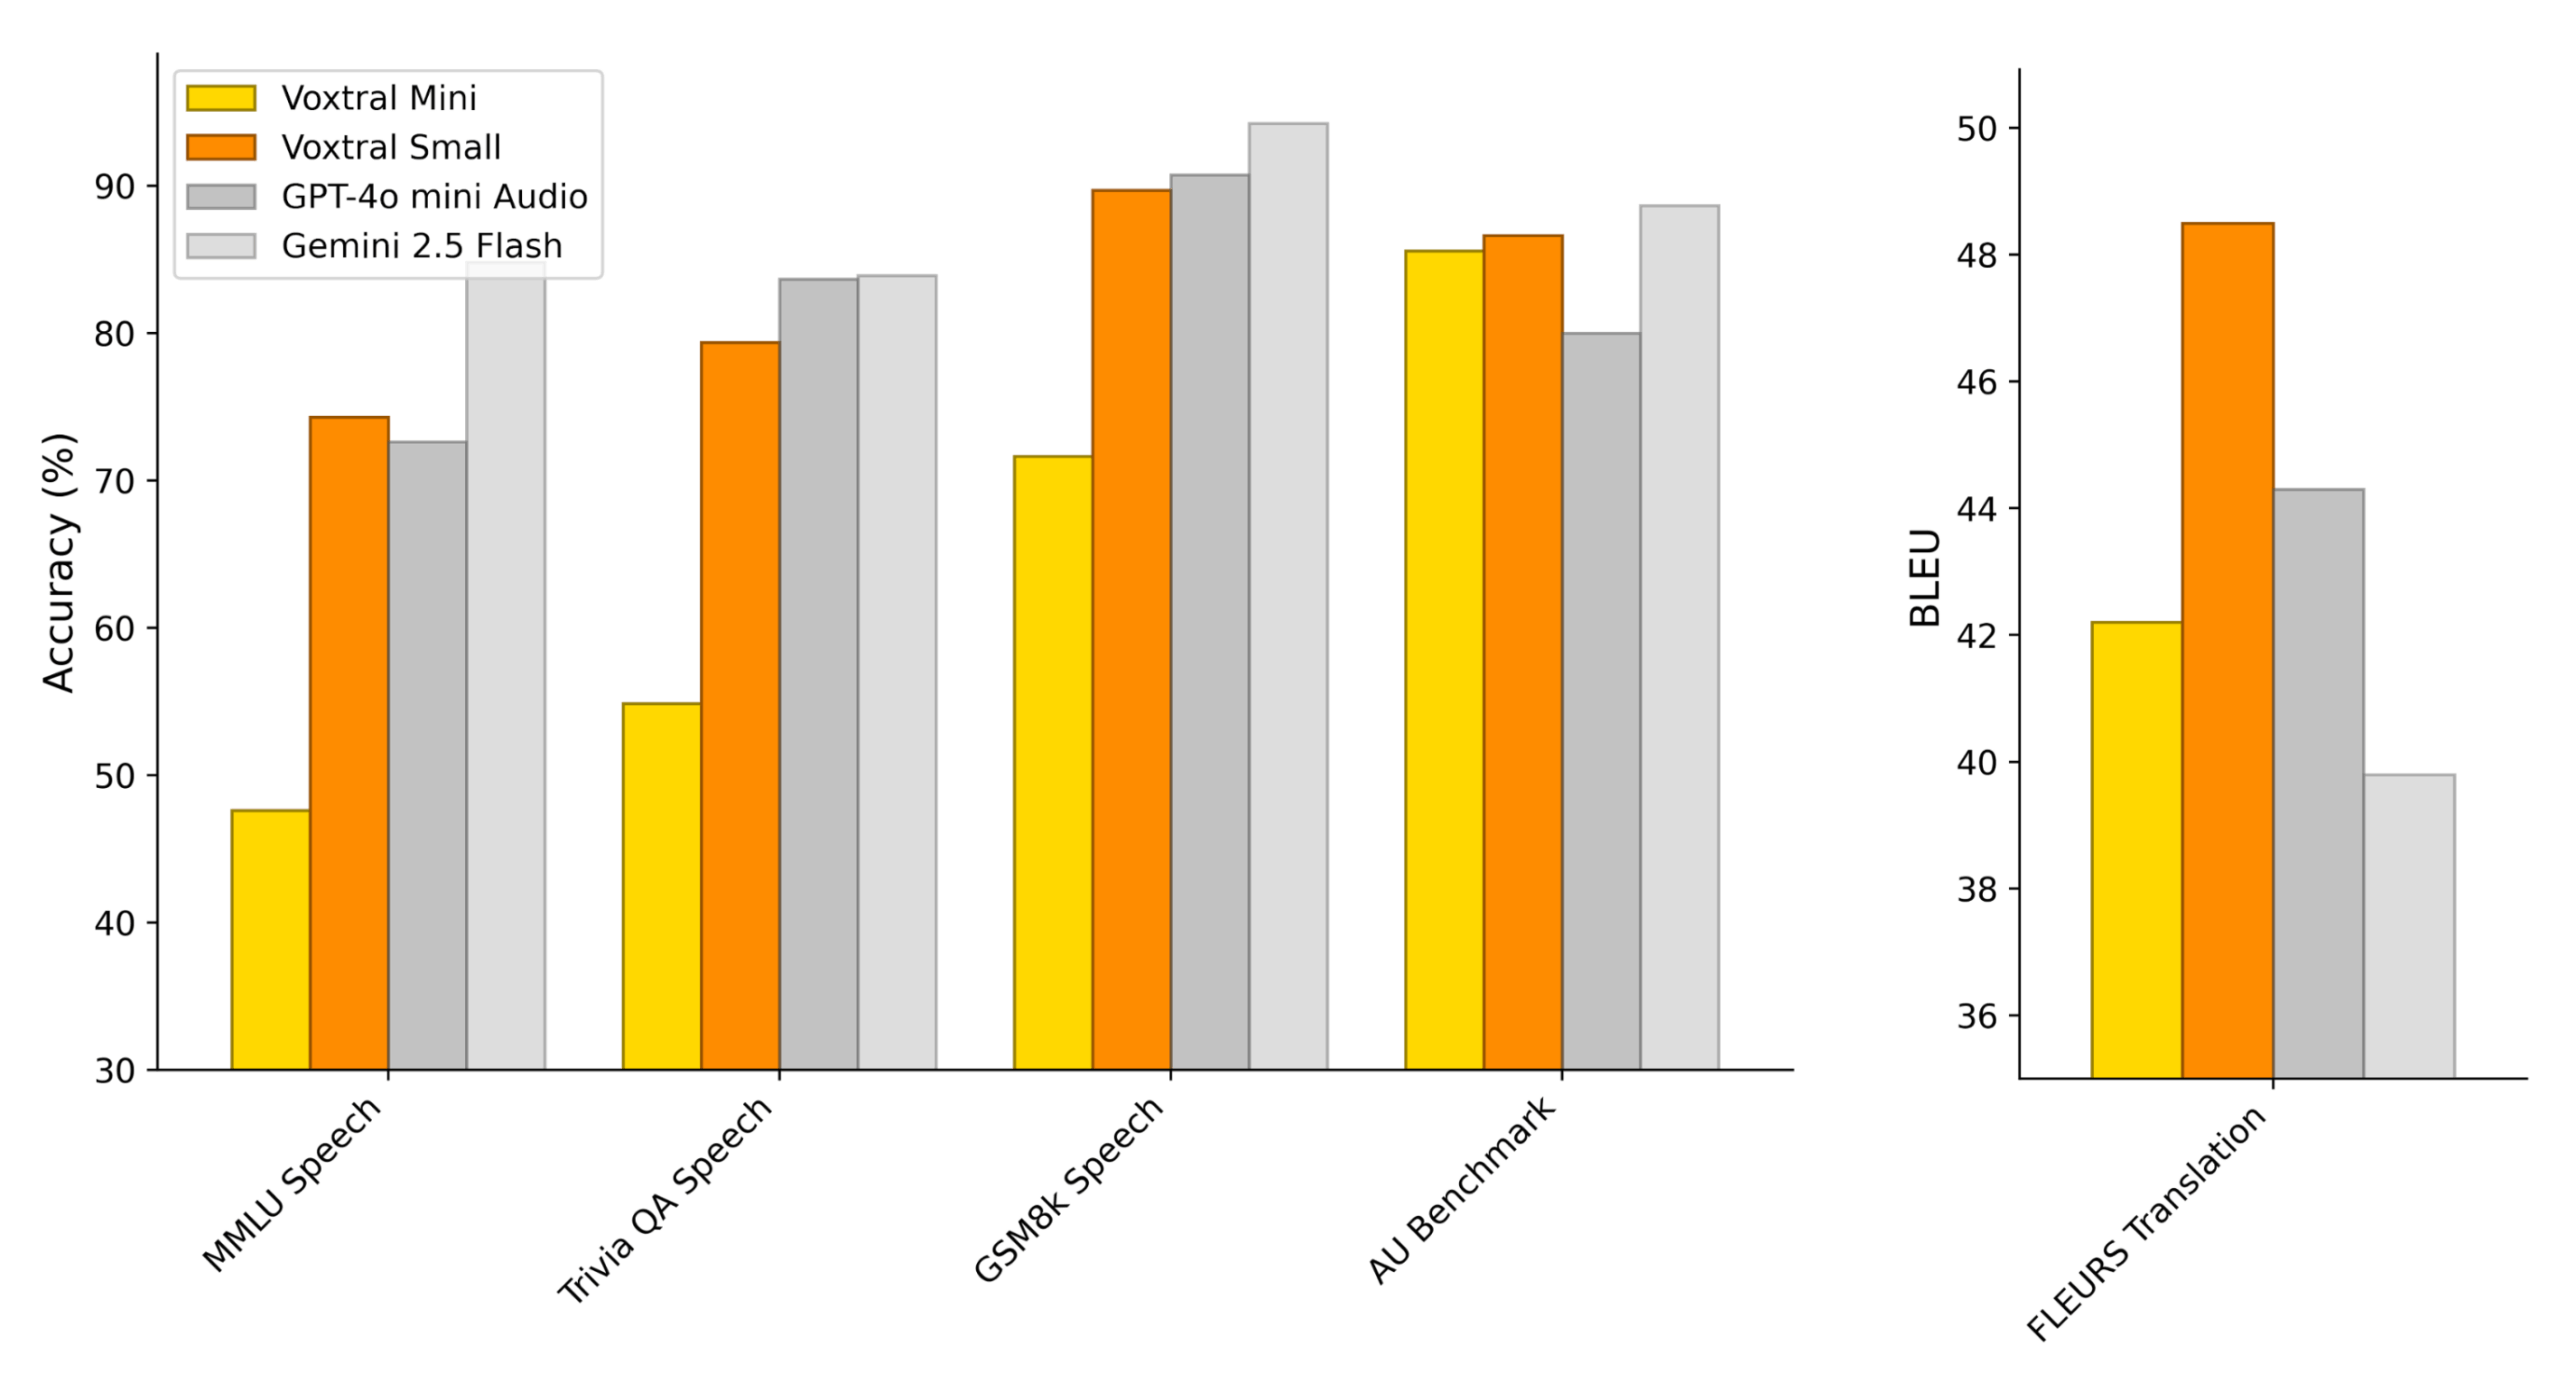
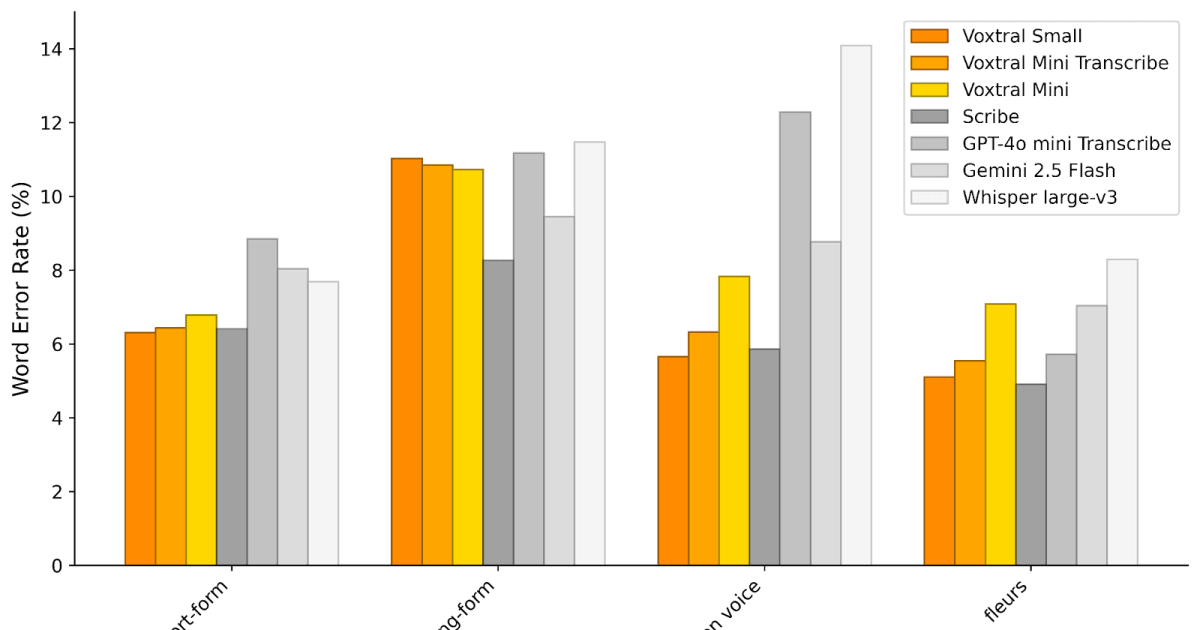
ค่าความผิดพลาดยิ่งต่ำยิ่งดี โดย WER เป็นค่าเฉลี่ยจาก 45 ภาษาที่ทั้ง 7 โมเดลรองรับ ส่วน Japanese, Korean, Thai และ Chinese ใช้ CER แทน WER
| Factor | Voxtral Small Transcribe 3 | Voxtral Mini Transcribe 3 | Whisper | Scribe v2 | Gemini 3.5 Transcribe | Microsoft AI Transcribe 2 |
|---|---|---|---|---|---|---|
| WER (บังคับ/ตรวจจับภาษา) | 4.1% / 4.0% | 4.6% / 4.5% | 16.0% / 14.9% | 4.9% / 4.9% | 6.1% / 4.5% | 4.1% / 4.0% |
| Concatenated Minimum Permutation WER | 18.4% | 18.6% | ไม่มีข้อมูลในกราฟ | 23.0% | 38.4% | 20.3% |
ข้อจำกัดคือกราฟชุดหลังไม่มี Whisper และผลเป็น macro-average จากชุดภาษาที่แหล่งข้อมูลระบุเท่านั้น.
จุดแข็งและข้อจำกัดที่ควรรู้ก่อนใช้งาน
Voxtral 3 เด่นตรงที่ฟังและตอบโต้ได้หลายภาษา แยกผู้พูด ใช้ context biasing กับคำศัพท์เฉพาะ และตรวจจับจังหวะจบประโยคได้ เหมาะกับ contact center หรือผู้ช่วยเสียงที่ต้องทำงานต่อเนื่องหลายขั้นตอน
ข้อดี
- +รองรับหลายภาษา พร้อมแยกผู้พูดและตรวจจับจังหวะจบประโยค
- +ปรับอารมณ์เสียง เชื่อมต่อเครื่องมือหลายขั้นตอน และควบคุมข้อมูลได้
ข้อเสีย
- −แหล่งข้อมูลไม่ได้ระบุรายละเอียดราคาครบทุกโมเดล
- −ผลทดสอบไม่ได้แยกทุกภาษา และผลใช้งานจริงขึ้นกับระบบหรือเครื่องมือที่เชื่อมต่อ
ค่าใช้จ่ายและภาระที่ไม่ได้อยู่ในตัวเลขต่อนาที
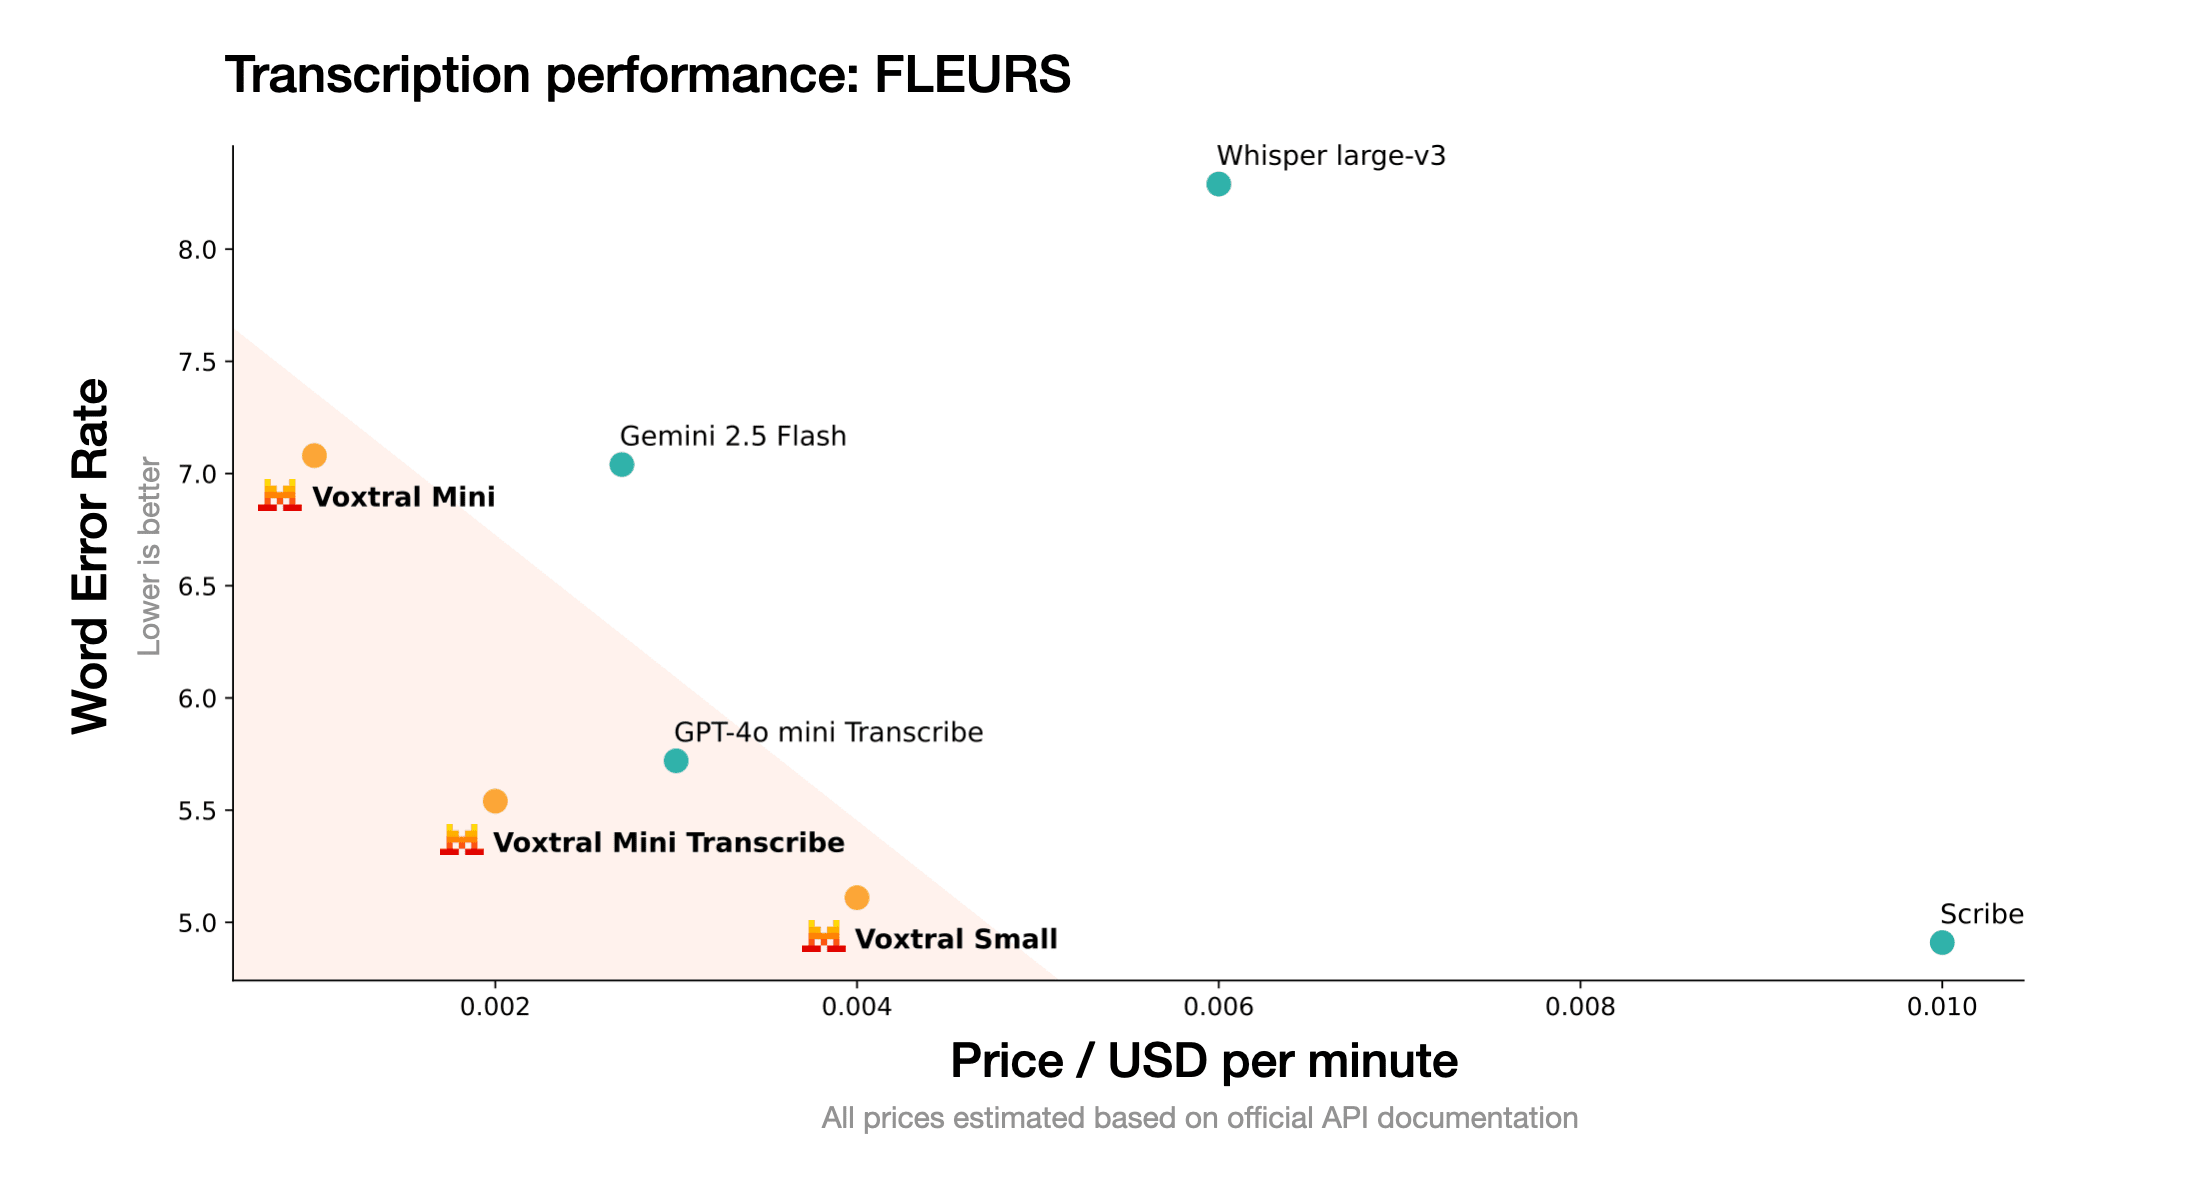
Voxtral Mini Transcribe 3 ระบุราคาไว้ที่ 0.0035 ดอลลาร์ต่อนาที แต่ตัวเลขนี้ไม่ได้ครอบคลุมรูปแบบการใช้งานทั้งหมด เพราะองค์กรยังต้องเลือกว่าจะใช้ EU-hosted API หรือดูแลโครงสร้างพื้นฐานสำหรับ self-deployment เอง
อีกประเด็นคือการควบคุมว่าเสียงจะถูกประมวลผลที่ไหนและเก็บไว้นานแค่ไหน ส่วนงานที่ต้องการ Pro Voice ต้องเตรียมเสียงตัวอย่าง 30 นาที เพื่อให้ระบบปรับลักษณะเสียง อารมณ์ และสไตล์การพูดได้ละเอียดขึ้น โดยแหล่งข้อมูลไม่ได้ระบุค่าใช้จ่ายเพิ่มเติมของส่วนเหล่านี้
เหมาะกับใคร และใครควรรอดูข้อมูลเพิ่ม
Voxtral 3 เหมาะกับศูนย์บริการ ผู้ให้บริการเสมือน และผู้ช่วยแบบแฮนด์ฟรีที่ต้องฟัง เข้าใจ พูดคุย และทำงานหลายขั้นตอนผ่านระบบที่เชื่อมต่อกัน เหมาะกับองค์กรที่ต้องการควบคุมสถานที่ประมวลผลเสียง การจัดการข้อมูล และการเก็บบทสนทนา
ส่วนทีมที่ต้องการราคาใช้งานจริงครบทุกองค์ประกอบ หรือรายละเอียดการติดตั้งเชิงลึก ควรรอข้อมูลเพิ่มเติมก่อนตัดสินใจ เพราะแหล่งข้อมูลนี้ยังไม่ได้ระบุรายละเอียดดังกล่าวครบถ้วน
คำถามสำคัญไม่ใช่แค่ระบบฟังรู้เรื่องหรือไม่
Voxtral 3 รวมการฟัง การให้เหตุผล การเรียกใช้เครื่องมือ และการพูดไว้ใน real-time streaming pipeline เดียวกัน จุดสำคัญจึงไม่ใช่แค่ถอดเสียงแม่น แต่คือระบบเข้าใจบริบท แล้วทำงานต่อให้จบได้หรือไม่
เวลาประเมิน ควรเริ่มจาก workflow จริง เช่น รับคำขอ ตรวจข้อมูลในระบบ เรียกใช้เครื่องมือ และตอบกลับอย่างต่อเนื่อง ถ้าต้องการแค่แปลงเสียงเป็นข้อความ ความสามารถของ Voxtral 3 อาจเกินความจำเป็น แต่ถ้าต้องการ voice agent ที่ลงมือทำงานได้ ต้องดูทั้งกระบวนการครับ