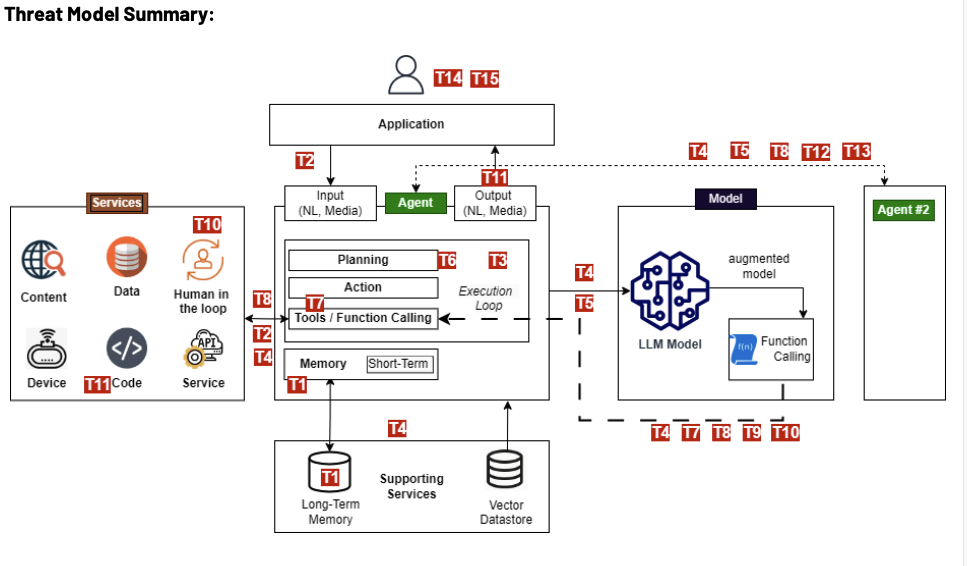
Microsoft มองว่า AI agents คล้าย insider threat เพราะ frontier models คาดเดาไม่ได้ และถูกให้สิทธิ์เข้าถึงข้อมูลกับเครื่องมือที่สร้างความเสียหายได้ จึงไม่ควรปล่อยให้ผู้พัฒนาโมเดลเป็นคนตรวจสอบ agent ของตัวเอง
Guardian Agents ใน Project Perception ทำหน้าที่เฝ้าดูพฤติกรรม agent ส่วน Microsoft Defender ตรวจจับ agent ได้ถึง 60 ประเภท พร้อมจำกัดสิทธิ์ตามงาน และขออนุมัติจากคนเมื่อพบการตัดสินใจเสี่ยง
ข้อดีคือองค์กรมีระบบคุมแยกจากผู้ผลิตโมเดล แต่ข้อจำกัดคือภาระความรับผิดชอบยังอยู่กับองค์กร ต้องดูแลสิทธิ์ ข้อมูล และระบบตรวจสอบเองครับ
ระบบเฝ้าระวังเอเจนต์ของ Microsoft
Guardian Agents ทำหน้าที่เหมือนคนกลางคอยดูพฤติกรรมของ AI agents ขณะที่ Open Agent Safety Platform แยกเอเจนต์ไว้ในสภาพแวดล้อมที่ปลอดภัย และสามารถหยุดการทำงานที่เสี่ยงได้
แนวคิดนี้เหมาะกับงานที่เอเจนต์เข้าถึงข้อมูลหรือเครื่องมือสำคัญ เพราะระบบจะจำกัดสิทธิ์ตามงาน และส่งต่อให้มนุษย์อนุมัติเมื่อพบการตัดสินใจที่อันตราย
เมื่อเอเจนต์ที่ช่วยงานอาจกลายเป็นความเสี่ยงภายใน
ลองนึกภาพองค์กรที่เปิดให้เอเจนต์เข้าถึงข้อมูลสำคัญและเครื่องมือที่ทำงานแทนบริษัทได้ หากเอเจนต์ตัดสินใจพลาด ผลกระทบอาจไม่ต่างจากพนักงานภายในที่ใช้อำนาจผิดทาง
Microsoft ระบุว่า frontier models ถูกฝึกมาให้ทำงานให้สำเร็จ ไม่ได้ถูกฝึกให้เข้าใจบรรทัดฐานหรือวิจารณญาณขององค์กร จึงอาจคาดเดาไม่ได้ แม้ไม่ได้มีเจตนาร้ายก็ตาม
Microsoft วางระบบควบคุมเอเจนต์ไว้ตรงไหน
Microsoft วางโซลูชันนี้ไว้ในธุรกิจความปลอดภัยของตัวเองที่เชื่อมกับ cloud โดยมี Guardian Agents เป็นตัวเฝ้าดูเอเจนต์ และเพิ่มความสามารถตรวจจับเอเจนต์ใน Microsoft Defender ส่วน Project Perception คือฐานระบบที่รวม red team, blue team และ green team ไว้ทดสอบ ตรวจหา และแก้ช่องโหว่
แนวคิดหลักคือแยกผู้จัดหา intelligence ออกจากผู้มีอำนาจควบคุม เพราะผู้สร้างโมเดลไม่ควรเป็นคนเดียวกับผู้ตรวจสอบพฤติกรรมของเอเจนต์ องค์กรจึงควรมีระบบอิสระไว้จำกัดสิทธิ์ ตรวจการตัดสินใจ และขอ human approval เมื่อเจอความเสี่ยง.
จาก Project Perception สู่ Guardian Agents
Project Perception เริ่มจากสมมติฐานว่าแฮ็กเกอร์มาจากภายนอก จึงแบ่งงานเป็น red team โจมตี, blue team ตรวจหา และ green team แก้ช่องโหว่ ส่วน Guardian Agents มองเอเจนต์ที่องค์กรใช้อยู่เองเป็นความเสี่ยงแบบ insider threat
| Factor | Project Perception | Guardian Agents และเครื่องมือรุ่นใหม่ |
|---|---|---|
| แหล่งความเสี่ยง | แฮ็กเกอร์จากภายนอก | เอเจนต์ที่องค์กรนำมาใช้งานเอง |
| แนวทางหลัก | โจมตี ตรวจหา และแก้ช่องโหว่ | ตรวจพฤติกรรมและควบคุมสิทธิ์ของเอเจนต์ |
| การตอบสนอง | ประเมินช่องโหว่แล้วแก้ไข | จำกัดข้อมูล ปรับสิทธิ์ตามงาน และขอ human approval เมื่อเสี่ยง |
Microsoft Defender ยังตรวจหาเอเจนต์ที่พนักงานนำมาใช้ได้ถึง 60 ประเภท รวมถึง Claude Code และ Codex.
ใช้งานจริงแล้วระบบคุมเอเจนต์ทำอะไรได้บ้าง
Guardian Agents ทำหน้าที่เฝ้าดูพฤติกรรมของเอเจนต์ในองค์กร เหมาะกับงานที่เอเจนต์ต้องแตะข้อมูลหรือเครื่องมือสำคัญ เพื่อให้ทีมเห็นความผิดปกติได้เร็วขึ้น
Microsoft Defender ตรวจจับเอเจนต์ที่พนักงานนำมาใช้ได้สูงสุด 60 ประเภท รวมถึง Claude Code, Codex และ OpenClaw ทำให้ฝ่ายไอทีเห็นภาพว่าในองค์กรมีเอเจนต์อะไรทำงานอยู่บ้าง
ถ้าเอเจนต์ต้องเข้าถึงข้อมูลหรือระบบ ระบบสามารถจำกัดสิทธิ์และปรับตามภารกิจได้ และเมื่อดูเหมือนกำลังตัดสินใจเสี่ยง ก็ขอการอนุมัติจากมนุษย์ก่อนดำเนินการต่อได้
Microsoft ต่างจากแนวทางของ OpenAI และ Anthropic อย่างไร
Microsoft วางตัวเป็นผู้ตรวจสอบและควบคุมเอเจนต์ โดยเสนอให้ระบบนี้แยกจากผู้จัดหาโมเดล ส่วน OpenAI และ Anthropic ในบทความถูกพูดถึงในฐานะผู้พัฒนาเทคโนโลยีและระบบความปลอดภัยของตัวเอง
| Factor | Microsoft | OpenAI | Anthropic |
|---|---|---|---|
| บทบาทด้านความปลอดภัย | ระบบตรวจสอบและควบคุมแยกจากผู้จัดหาเอเจนต์ | Daybreak สำหรับสแกนช่องโหว่ | Mythos และ Fable เป็น hacking models |
| ความสัมพันธ์กับ Microsoft | ผู้เสนอแนวคิดและผลิตภัณฑ์ควบคุมเอเจนต์ | พันธมิตรทางธุรกิจและลูกค้า cloud รายใหญ่ | บริษัทที่ Microsoft ลงทุนและเป็นพันธมิตรทางธุรกิจ |
| จุดที่ต้องระวัง | เตือนว่าไม่ควรฝากความรับผิดชอบไว้กับ model provider | เป็นหนึ่งในผู้จัดหาโมเดลที่ควรมีระบบแยกตรวจสอบ | เป็นหนึ่งในผู้จัดหาโมเดลที่ควรมีระบบแยกตรวจสอบ |
จุดน่าสนใจคือ Microsoft มีผลประโยชน์ร่วมกับทั้งสองบริษัท แต่ก็ยังเตือนให้องค์กรแยกผู้จัดหา intelligence ออกจากผู้มีอำนาจควบคุมอยู่ดี
จุดแข็งและข้อจำกัดของแนวคิดนี้
แนวคิดนี้ช่วยแยกผู้สร้างเอเจนต์ออกจากระบบที่คอยตรวจสอบ ทำให้องค์กรควบคุมการเข้าถึงข้อมูลและระบบได้ดีขึ้น อีกทั้งยังปรับสิทธิ์ตามภารกิจ และขอมนุษย์อนุมัติเมื่อพบการตัดสินใจเสี่ยง
ข้อดี
- +แยกผู้ตรวจสอบออกจากผู้สร้างเอเจนต์
- +ปรับสิทธิ์ตามภารกิจและมีมนุษย์ร่วมอนุมัติ
ข้อเสีย
- −โมเดลไม่ได้ถูกกล่าวหาว่ามุ่งร้ายโดยตรง แต่คาดเดาไม่ได้
- −Microsoft มีผลประโยชน์ทางธุรกิจจากการขายระบบนี้
ภาระที่องค์กรต้องรับเพิ่มนอกเหนือจากค่าผลิตภัณฑ์
ต้นทุนไม่ได้มีแค่ค่าซื้อระบบ แต่รวมถึงการวางระบบแยกเพื่อเฝ้าดูเอเจนต์จากผู้ให้บริการโมเดลด้วย องค์กรยังต้องกำหนดว่าเอเจนต์แต่ละตัวเข้าถึงข้อมูลและเครื่องมืออะไรได้บ้าง แล้วปรับสิทธิ์ตามงานที่ทำ
เมื่อมีเอเจนต์หลายประเภทเข้ามาใช้งาน การตรวจจับและจัดการพฤติกรรมก็ซับซ้อนขึ้น งานที่ดูเสี่ยงอาจต้องรอมนุษย์อนุมัติ ทำให้กระบวนการทำงานช้าลงและต้องมีคนรับผิดชอบเพิ่ม
แหล่งข้อมูลไม่ได้ระบุราคาหรือค่าใช้จ่ายจริง จึงประเมินได้เพียงว่าองค์กรต้องรับภาระด้านการกำกับดูแล การตั้งค่า และการตรวจสอบต่อเนื่องนอกเหนือจากค่าผลิตภัณฑ์ครับ
ทางเลือกที่อุตสาหกรรมกำลังผลักดัน
แนวคิดมองเอเจนต์เป็น insider threat กำลังขยายไปทั้งอุตสาหกรรม Microsoft เข้าร่วม Nvidia Open Agent Safety Platform ที่มีบริษัทเทคโนโลยีสนับสนุนมากกว่า 100 แห่ง
แพลตฟอร์มนี้แยกเอเจนต์ไว้ในสภาพแวดล้อมปลอดภัย พร้อมตรวจสอบและหยุดพฤติกรรมผ่านฮาร์ดแวร์ คล้าย kill switch สำหรับกรณีที่เอเจนต์เริ่มทำงานเสี่ยง
สุดท้ายองค์กรต้องถามให้ชัดว่า ใครควรมีอำนาจเหนือเอเจนต์—ผู้สร้างโมเดล หรือระบบกำกับดูแลที่องค์กรควบคุมเอง