Intel D270 คือ GPU สำหรับงาน AI inference ในดาต้าเซ็นเตอร์ยุค agentic AI รองรับหน่วยความจำสูงสุด 480 GB LPDDR5X จึงเหมาะกับงานที่ต้องใช้ context ขนาดยาวและหลายเซสชันพร้อมกัน
ตัว GPU เน้นการประมวลผล prefill ด้วย 32 Xᵉ3P cores และ 256 XMX engines พร้อมรองรับการติดตั้งบนโครงสร้าง PCIe 5.0 มาตรฐาน ใช้ระบบระบายความร้อนด้วยอากาศ และไม่ต้องปรับระบบเป็น liquid cooling.
Intel D270 อยู่ตรงไหนในตระกูล D-series
Intel D270 คือ data center GPU ในตระกูล D-series ที่วางตำแหน่งมาสำหรับ production AI inference มากกว่าการฝึกโมเดลขนาดใหญ่ระดับ massive scale จุดเน้นจึงอยู่ที่การรัน AI ในระบบจริง เช่น prompt processing, long context และการรองรับหลายเซสชันพร้อมกัน
กลุ่มเป้าหมายคือ enterprise AI, SaaS, GPUaaS รวมถึง government และ sovereign-cloud โดยให้ความสำคัญกับ memory capacity, การใช้พลังงานอย่างมีประสิทธิภาพ และการนำไปติดตั้งในระบบศูนย์ข้อมูลได้จริง เหมาะกับงานอย่าง AI assistant, coding assistant, RAG และ document understanding.
สิ่งที่เห็นจากตัวผลิตภัณฑ์และการติดตั้ง
ตัวผลิตภัณฑ์มาในฟอร์มแฟกเตอร์ PCIe 5.0 มาตรฐาน จึงออกแบบมาให้ติดตั้งกับเซิร์ฟเวอร์ที่มีอยู่ได้ โดยไม่ต้องใช้ระบบเครือข่ายเฉพาะหรือระบบ bespoke
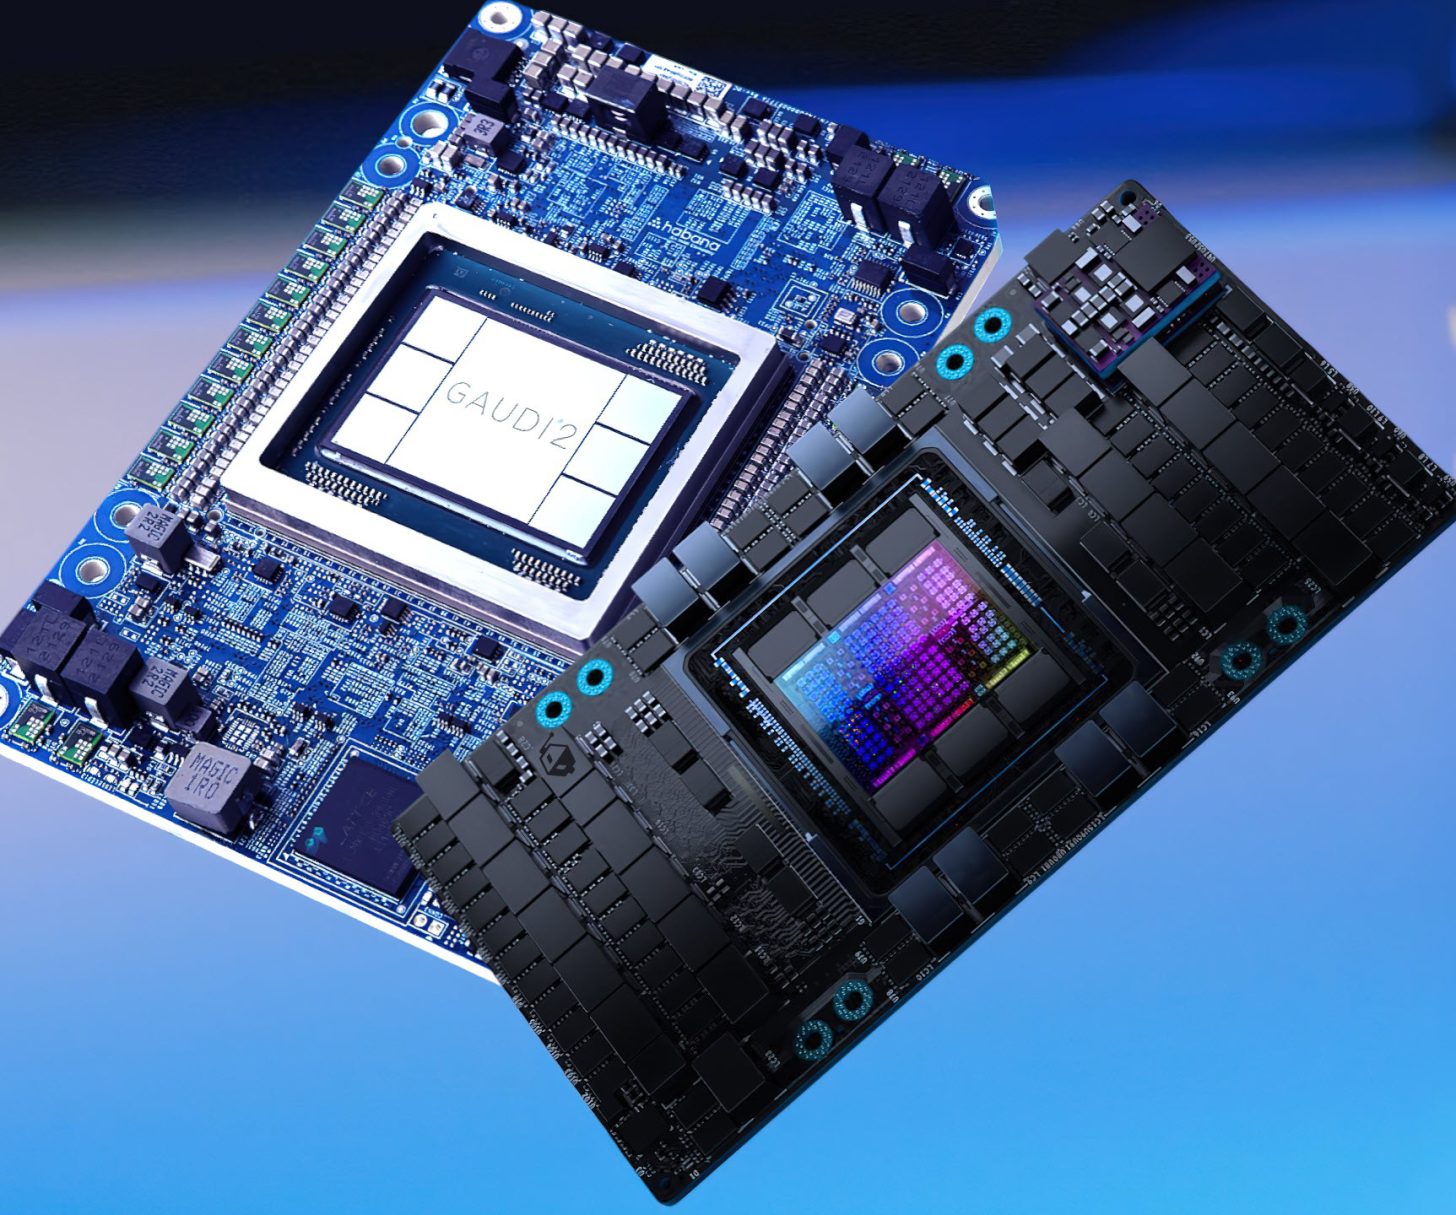
แนวทางระบายความร้อนเป็นแบบ air-cooled และมี passive cooling ในแร็กที่ใช้งานอยู่แล้ว ช่วยให้การประเมินไปจนถึงติดตั้งจริงไม่ต้องปรับระบบเป็น liquid cooling เพิ่ม โดยแหล่งข้อมูลไม่ได้ระบุขนาดหรือน้ำหนักของตัว GPU จึงไม่ควรสรุปรายละเอียดทางกายภาพเกินกว่านี้
เมื่อ AI หนึ่งคำสั่งกลายเป็นงานหลายรอบ
ลองนึกภาพทีมที่ส่งงานให้ agentic AI แล้วระบบต้องเรียกโมเดลหลายรอบ ใช้เครื่องมือ ค้นคืนข้อมูล ทำ reasoning ก่อนสร้างคำตอบกลับมา งานหนึ่งจึงไม่ได้จบในคำสั่งเดียว
พอ context ยาวขึ้นและมีหลายเซสชันทำงานพร้อมกัน ภาระ prefill ก็เพิ่มตามไปด้วย โดยเฉพาะงานที่มี retrieval หนักหรือ context แตะ 100K tokens ทีมจึงต้องการ GPU ที่เก็บโมเดลและ context ไว้ได้มากขึ้น เพื่อให้การทำงานต่อเนื่องและรองรับ concurrent sessions ได้ดีขึ้น.
D270 กับบทบาทใหม่ของ GPU สำหรับงานอนุมาน
Intel GPU D270 เป็นส่วนหนึ่งของ Intel GPU D-series ที่สร้างมาสำหรับยุค agentic AI โดยโฟกัสการรัน AI ใน production มากกว่าการฝึกโมเดลขนาดใหญ่
งานที่เหมาะคือ long-context RAG, enterprise AI assistant, coding assistant และ document understanding รวมถึง multimodal AI, diffusion models และ high-concurrency serving พูดง่ายๆ คือเหมาะกับระบบที่ต้องรับคำขอจากผู้ใช้หลายราย พร้อมประมวลผล prompt และ context ต่อเนื่องในงานจริง
แหล่งข้อมูลไม่ได้ระบุชื่อหรือสเปกของรุ่นก่อนหน้า จึงยังเทียบความต่างเชิงตัวเลขไม่ได้ จุดที่ยืนยันได้ของ D270 มีดังนี้
| Factor | Intel GPU D270 | รุ่นก่อนหน้า (ไม่ระบุในแหล่งข้อมูล) |
|---|---|---|
| หน่วยความจำ | สูงสุด 480 GB LPDDR5X | ไม่มีข้อมูล |
| แกนประมวลผล | 32 Xᵉ3P cores | ไม่มีข้อมูล |
| การเร่ง matrix | 256 XMX engines | ไม่มีข้อมูล |
D270 ยังระบุว่าใช้มาตรฐาน PCIe 5.0 และระบบระบายความร้อนแบบ air-cooled แต่แหล่งข้อมูลไม่มีข้อมูลของ predecessor ให้เทียบโดยตรง.
สเปกเหล่านี้ทำงานอย่างไรในสถานการณ์จริง
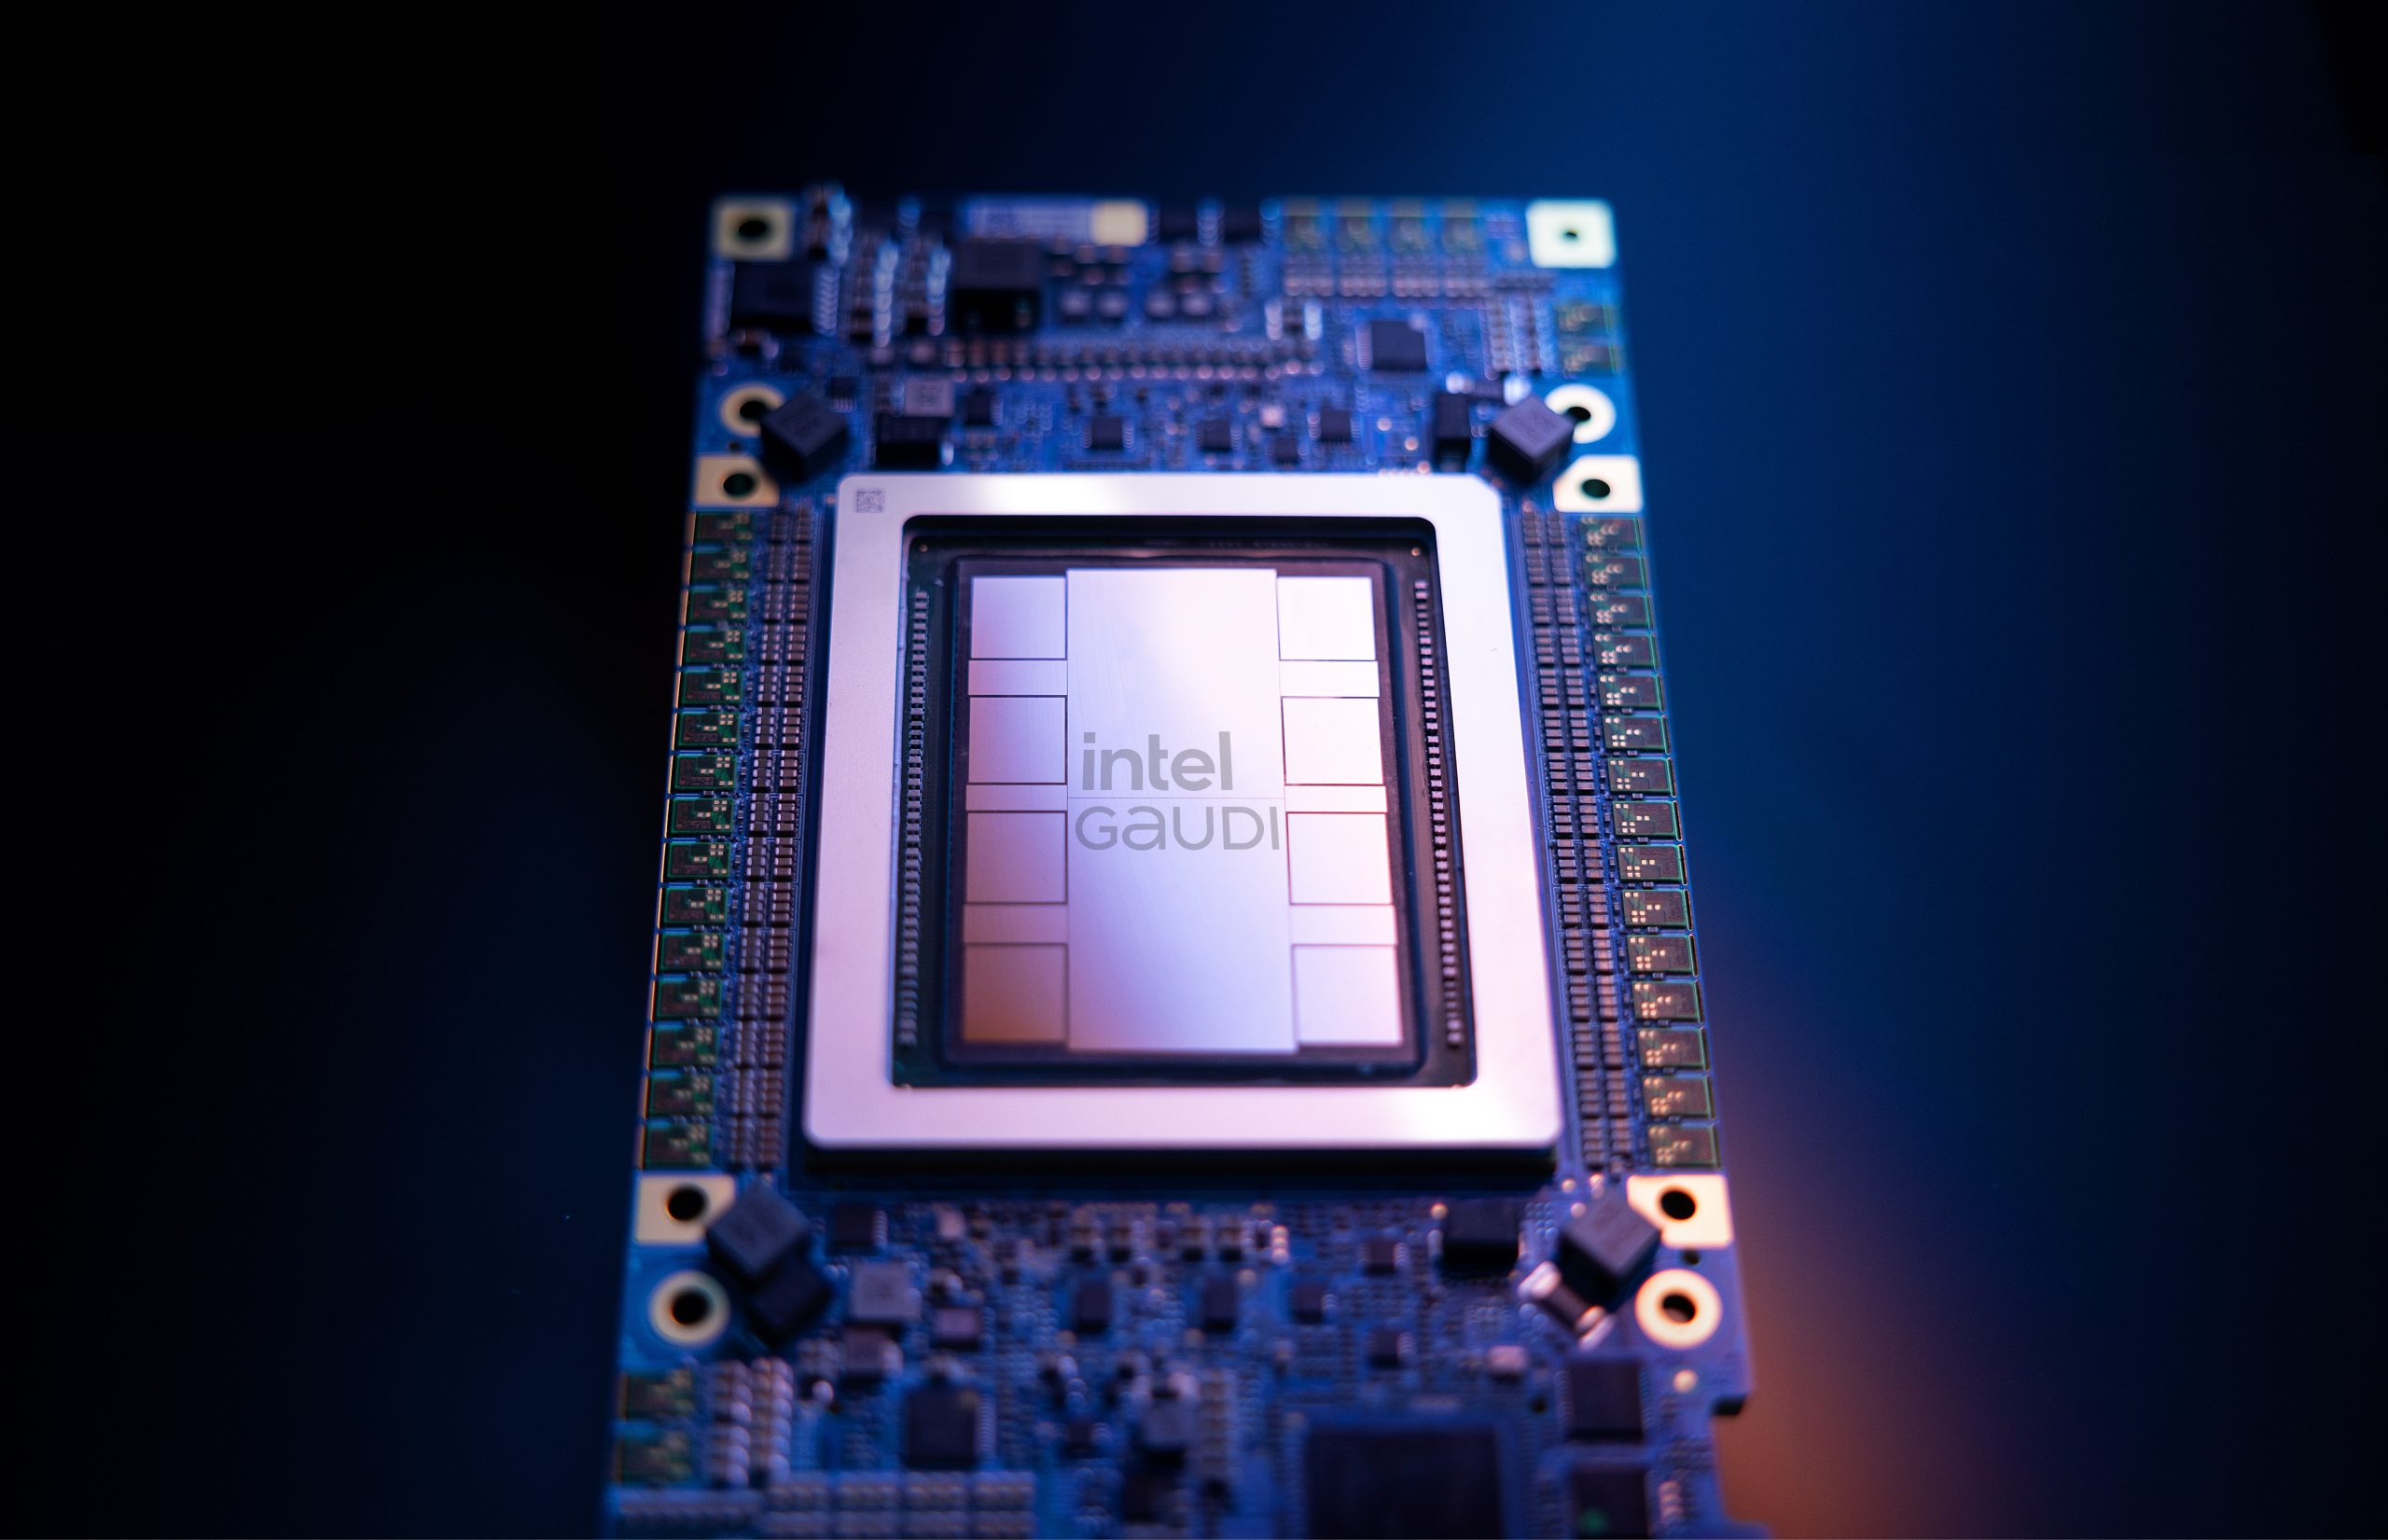
หน่วยความจำ LPDDR5X สูงสุด 480 GB ช่วยรองรับงาน long-context RAG ที่มี prompt ยาวและข้อมูลจากการค้นคืนจำนวนมาก รวมถึงการเติบโตของ KV cache ระหว่าง inference
สำหรับ agentic AI ที่ต้องประมวลผล prompt ยาว 32 Xᵉ3P cores และ 256 XMX engines ช่วยเร่งขั้นตอน prefill หรือการประมวลผล prompt ก่อนสร้างคำตอบ จึงเหมาะกับงานที่อ่านบริบทมากกว่าการเขียน
เมื่อระบบต้องรองรับหลายเซสชันพร้อมกัน และแต่ละงานมีการเรียกโมเดล ใช้เครื่องมือ และค้นข้อมูลหลายรอบ ความจุหน่วยความจำกับการออกแบบสำหรับ inference จะช่วยให้รองรับ workflow ลักษณะนี้ได้
ตัวการ์ดใช้ฟอร์มแฟกเตอร์ PCIe 5.0 และ passive cooling จึงเหมาะกับการประเมินหรือนำไปติดตั้งในดาต้าเซ็นเตอร์เดิม โดยไม่ต้องปรับเป็นระบบ liquid cooling ใหม่
เมื่อเทียบกับตัวเลือกอื่น ข้อมูลยังอยู่ตรงไหน
| Factor | Intel GPU D270 | RTX Pro 6000 |
|---|---|---|
| Performance | มี performance projection เทียบกัน แต่ไม่ระบุตัวเลข | มีการใช้เป็นคู่เปรียบเทียบ แต่ไม่มีตัวเลข |
| หน่วยความจำ | สูงสุด 480 GB LPDDR5X | ไม่มีข้อมูลเพียงพอ |
| เงื่อนไขเทียบความจุ | เทียบที่ bandwidth ใกล้เคียงกัน | เทียบที่ bandwidth ใกล้เคียงกัน |
ข้อมูล performance projection อ้างอิงข้อมูลสาธารณะและการวิเคราะห์ภายในของ Intel ณ กุมภาพันธ์ 2026 ผลลัพธ์ขึ้นกับการใช้งาน การตั้งค่า และปัจจัยอื่น ๆ จึงยังสรุปว่า D270 เหนือกว่า RTX Pro 6000 ไม่ได้จากข้อมูลชุดนี้.
จุดแข็งและข้อจำกัดที่ควรรู้ก่อนประเมิน
D270 เด่นที่หน่วยความจำ LPDDR5X สูงสุด 480 GB รองรับ context ยาว งาน prefill และหลาย session พร้อมกัน อีกทั้งใช้ PCIe มาตรฐาน ระบายความร้อนด้วยอากาศ และทำงานกับ vLLM กับ open PyTorch ecosystem ได้
ข้อดี
- +หน่วยความจำสูงสุด 480 GB
- +รองรับ context ยาวและหลาย session
- +เร่งการประมวลผล prefill
- +ใช้ PCIe มาตรฐานและระบายความร้อนด้วยอากาศ
- +รองรับ vLLM และ open PyTorch ecosystem
ข้อเสีย
- −แหล่งข้อมูลไม่ได้ระบุราคาจำหน่าย
- −ยังไม่มีผลทดสอบเต็มรูปแบบ
- −ไม่มีข้อมูลรุ่นย่อย
- −ไม่มีรายละเอียด performance ใน workload เฉพาะ
ค่าใช้จ่ายที่ต้องคิดนอกเหนือจากตัวการ์ด
ต้นทุนจริงไม่ได้จบที่ตัว GPU เพราะงานที่มี context ยาวและหลาย session อาจต้องวางแผนจำนวน GPU ให้เหมาะกับขนาดโมเดลกับ KV cache โดย D270 มีหน่วยความจำ LPDDR5X สูงสุด 480 GB ช่วยให้เก็บโมเดลและ context ไว้ในระบบได้มากขึ้น
ฝั่งโครงสร้างพื้นฐานยังต้องดูพลังงาน ความหนาแน่นในแร็ก และเซิร์ฟเวอร์ที่รองรับ PCIe 5.0 จุดเด่นคือใช้ระบบมาตรฐาน ระบายความร้อนด้วยอากาศ และไม่ต้องติดตั้ง liquid cooling ใหม่ แต่แหล่งข้อมูลไม่ได้ระบุราคาฮาร์ดแวร์ ค่าไฟ หรือค่าใช้จ่ายดำเนินงานจริง จึงยังสรุปต้นทุนเป็นตัวเลขไม่ได้
เหมาะกับใคร และใครควรรอข้อมูลเพิ่ม
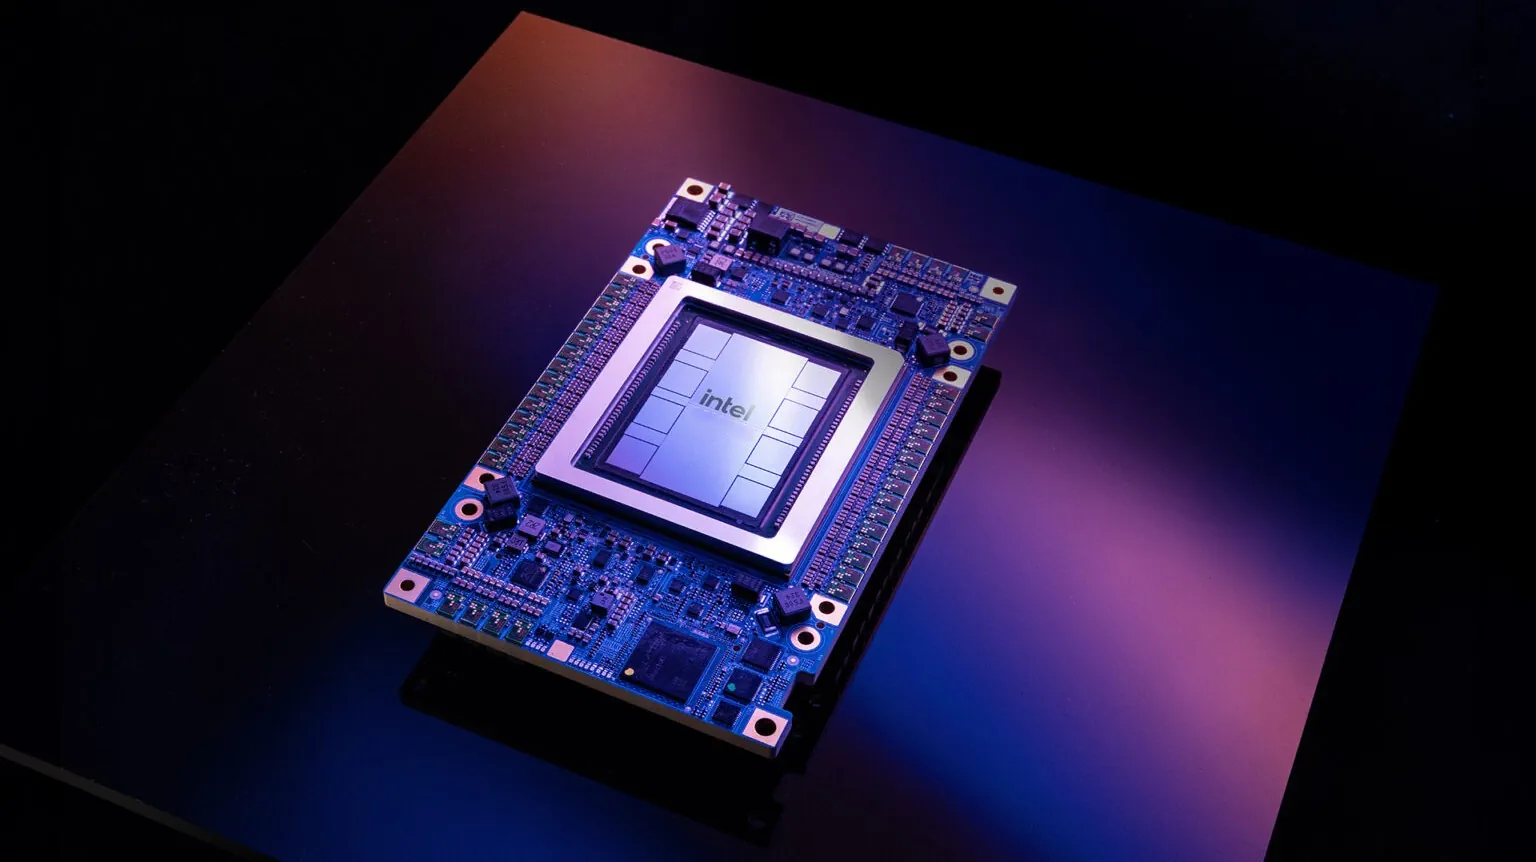
Intel D270 น่าพิจารณาสำหรับทีมที่วางระบบและใช้งาน AI inference ใน production โดยเฉพาะงาน enterprise AI, SaaS และ GPUaaS
เหมาะกับ
- System architect และ platform architect
- ผู้นำด้าน infrastructure และ cloud
- ผู้ตัดสินใจด้าน enterprise AI
- SaaS provider และ GPUaaS provider
- หน่วยงานภาครัฐหรือ sovereign cloud
- ผู้พัฒนา production inference
ลองชั่งน้ำหนักดู
- ทีมที่ต้องประเมินความเหมาะสมกับ AI inference roadmap
ข้ามได้เลย
- ผู้ที่ต้องการราคา ผลทดสอบเฉพาะงาน หรือรายละเอียดผลิตภัณฑ์ที่ยืนยันแล้ว — ควรรอข้อมูลเพิ่มก่อนตัดสินใจ
ขั้นต่อไปก่อนตัดสินใจนำไปใช้
ก่อนเลือก D270 ควรเทียบกับงานจริงของระบบ โดยดูขนาด context, จำนวน session ที่รันพร้อมกัน, ภาระ prefill และข้อจำกัดด้านพลังงาน รวมถึงการรองรับ long-context RAG, AI assistant หรือ coding assistant
จากนั้นเชื่อมต่อ Intel เพื่อประเมินว่า D270 เหมาะกับ AI inference roadmap ขององค์กรหรือไม่ ขอข้อมูลผลิตภัณฑ์เพิ่มเติม และติดตามรายละเอียดที่จะประกาศภายหลัง เพราะข้อมูลด้าน performance และการใช้งานจริงอาจขึ้นอยู่กับ workload กับ configuration ของแต่ละระบบ