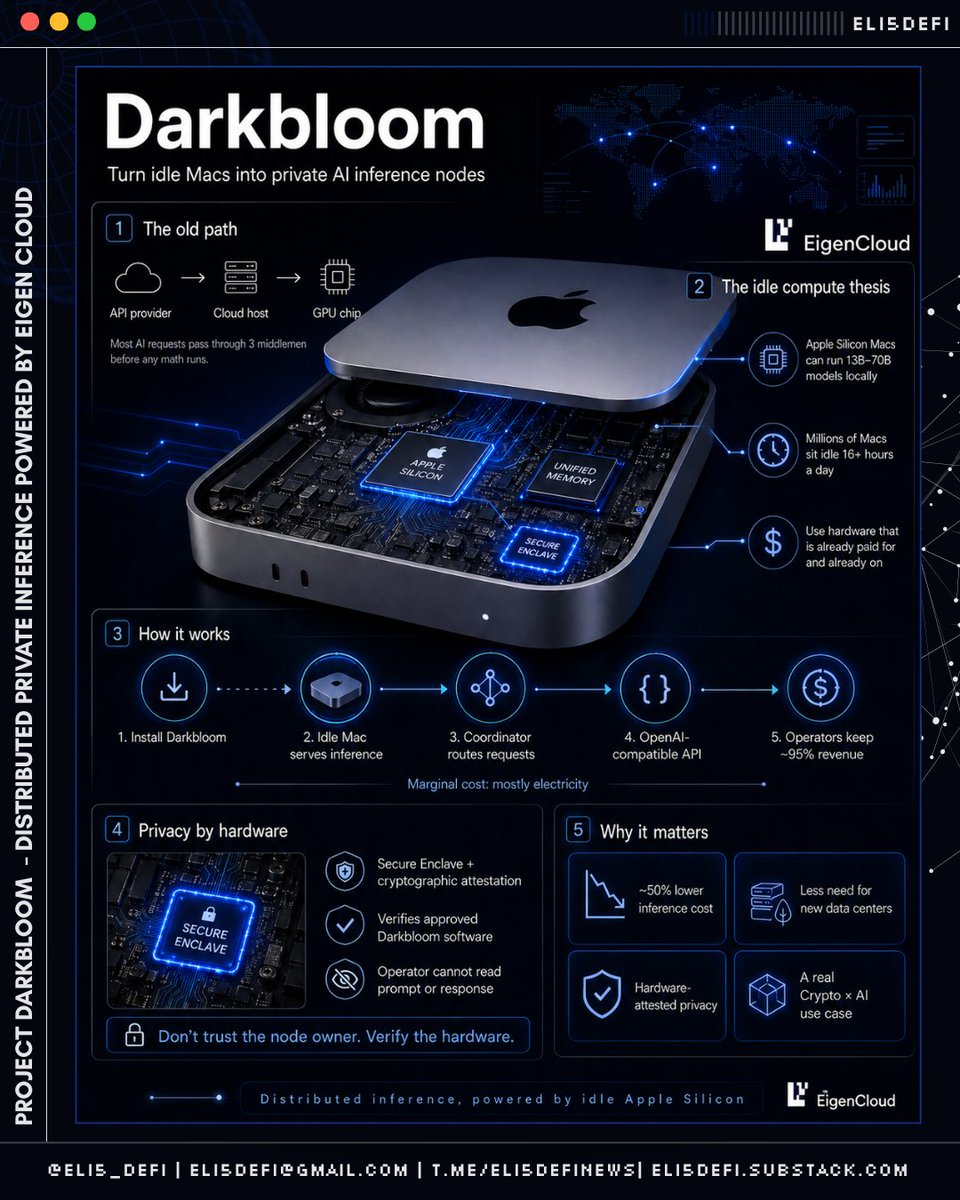
Apple ใช้ระบบ “Minions” เปลี่ยน Mac ที่ว่างอยู่ให้เป็นเครือข่ายประมวลผล AI ภายในองค์กร งานที่เคยรอคิว GPU กว่า 10 ชั่วโมง อาจลดเวลารอเหลือเพียงไม่กี่นาที ด้วยการกระจายงานย่อยไปยัง Mac ผ่านระบบ pull-based
ข้อจำกัดคือ Minions รองรับเฉพาะ AI inference และให้ Mac แต่ละเครื่องรันโมเดลทั้งตัว ไม่ได้แบ่งโมเดลข้ามเครื่อง ความลับของข้อมูลยังเป็นประเด็น เพราะทีมกังวลว่างานจะไปรันบนอุปกรณ์นอกกลุ่ม ส่วนต้นทุนโครงสร้างพื้นฐานเป็นศูนย์ตามที่งานวิจัยระบุ แต่ยังไม่รวมค่าไฟและการสึกหรอของฮาร์ดแวร์
จากคิว GPU หลายชั่วโมงสู่การใช้ Mac ที่ว่างอยู่
งาน AI บางงานเคยต้องรอคิว GPU มากกว่า 10 ชั่วโมง ทำให้การทดลองหรือประมวลผลสะดุด แม้ทีมจะมีงานพร้อมรันแล้วก็ตาม
Minions แก้ปัญหาด้วยการส่งงานย่อยไปยัง Mac ที่ว่างอยู่บนเครือข่าย แต่ละเครื่องรับงานไปรันแล้วส่งผลลัพธ์กลับ ระบบจึงลดเวลารอจากหลายชั่วโมงเหลือเพียงไม่กี่นาทีในบางกรณี.
Minions อยู่ตรงไหนในระบบประมวลผลของ Apple
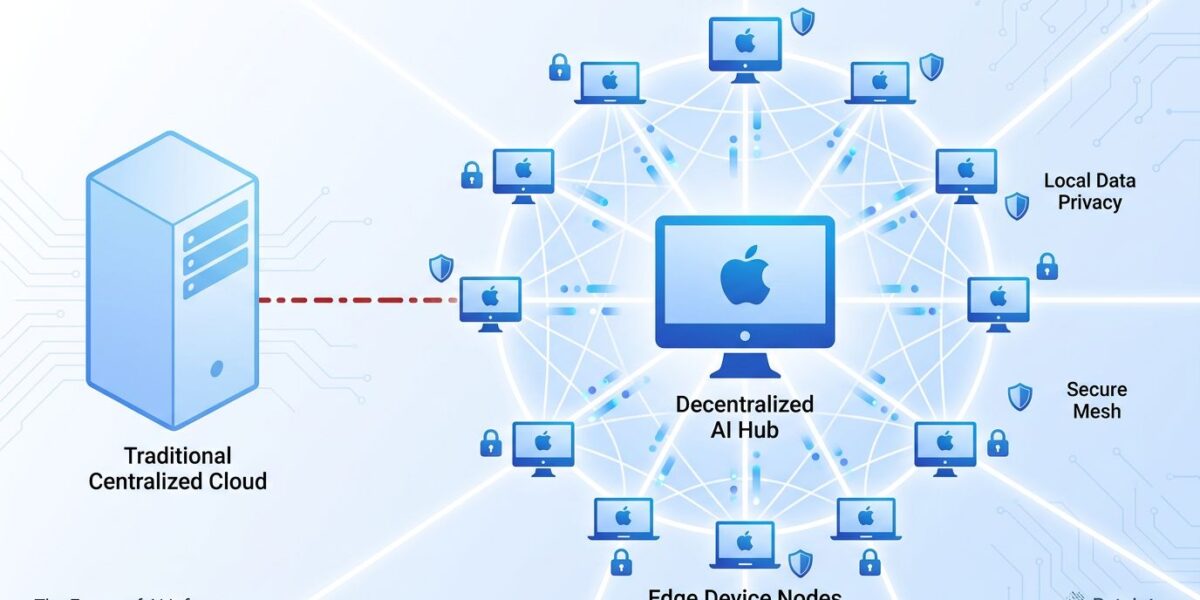
Minions คือระบบภายในของ Apple ที่รวม Mac ซึ่งใช้ชิป Apple Silicon ให้ทำงานเป็น “virtual GPU cloud” สำหรับ AI inference โดยรองรับทั้งงาน embeddings และ text generation ผ่านโมเดลที่ติดตั้งบนเครื่อง
ระบบนี้จึงเป็นอีกชั้นของโครงสร้างประมวลผล นอกเหนือจากศูนย์ข้อมูลและ cloud providers ภายนอกของ Apple ส่วนงานที่ซับซ้อนกว่าใน Private Cloud Compute ก็ยังใช้ Nvidia GPUs บน Google Cloud ด้วย.
วิธีทำงานที่เปลี่ยน Mac แต่ละเครื่องให้เป็นแรงประมวลผลร่วมกัน
| แนวทางเดิม | Minions |
|---|---|
| งานค้างอยู่ใน GPU queue หรือขอ GPU เพิ่ม | Minion Server แบ่งงานเป็น subtasks เก็บใน PostgreSQL |
| ต้องรอคิวจากทรัพยากรส่วนกลาง | Mac แต่ละเครื่องดึงงานผ่าน REST APIs เอง ไม่มี central scheduler |
| เพิ่มงานอาจต้องขอ GPU และโครงสร้างพื้นฐาน | Mac อ่านข้อมูลจาก S3 โหลดโมเดลเมื่อจำเป็น รันด้วย GPU ในเครื่อง แล้วส่งผลกลับ S3 |
ถ้า Mac หลับ หลุดเครือข่าย หรือผู้ใช้หยุด Executor งานที่ยังไม่เสร็จจะกลับเข้า queue ผ่าน Minion Watchdog.
เมื่อคิวงานยาวกลายเป็นงานที่รันได้ระหว่างพักเครื่อง
ลองนึกภาพทีมที่ส่งงาน AI แล้วต้องรอคิว GPU นานกว่า 10 ชั่วโมง สมาชิกทีมส่งข้อความใน Slack ขอให้คนอื่นเปิด Minion Executor บน Mac ที่ว่าง และช่วยโปรเจกต์หรือ task ที่กำหนด
เมื่อมี Mac เข้าร่วม งานที่ค้างก็ถูกกระจายไปทำบนเครื่องเหล่านั้น ทำให้เวลารอเหลือเพียงไม่กี่นาทีในบางกรณี เหมาะกับงาน inference เช่น สร้าง embeddings หรือให้โมเดลภาษาสร้างข้อความ แต่ทีมยังต้องคุยเรื่องข้อมูลว่าจะยอมให้รันนอกกลุ่มตัวเองหรือไม่
ตั้งแต่งานฝังเวกเตอร์ถึงการสร้างข้อความบน Mac
Minions รองรับงาน inference หลัก 2 แบบ: สร้าง embeddings ด้วยโมเดล Hugging Face แบบโอเพนซอร์ส และสร้างข้อความจากโมเดลภาษาขนาดใหญ่ผ่าน Ollama ที่ติดตั้งบน Mac แต่ละเครื่อง เหมาะกับทีมที่มีงานย่อยหลายชิ้นและต้องการใช้เครื่องที่ว่างอยู่ให้เกิดประโยชน์
ตัวระบบอ่านอินพุตจาก Amazon S3 แล้วส่งผลลัพธ์กลับไปเก็บที่ S3 ส่วนเจ้าของเครื่องเลือกได้ว่าจะให้งานของทีมไหนหรือโปรเจกต์ใดมาก่อนด้วย dynamic task binding หรือปล่อยตามคิว first-in, first-out ก็ได้.
Minions แตกต่างจากระบบกระจายงานแบบอื่นอย่างไร
| แนวคิด | ลักษณะงาน | บริบทการใช้งาน |
|---|---|---|
| Minions | AI inference บน Apple Silicon โดยแต่ละ Mac รันโมเดลทั้งชุดกับงานของตัวเอง | ใช้ภายในองค์กร แบ่งงานไปยัง Mac ที่ว่าง และจัดกลุ่มฐานข้อมูลกับเครื่องตามทีมได้ |
| OpenClaw home lab | รันโมเดลทั้งหมดบน hardware และ unified memory ของ Mac เครื่องเดียว | ใช้ใน home lab ไม่ใช่ระบบรวมเครื่องภายในองค์กร |
| SETI@home / Folding@home | แจกงานเป็นชิ้นเล็ก ๆ ไปยังเครื่องที่ว่าง | เป็นแนวคิด volunteer computing แต่แหล่งข้อมูลไม่ได้ระบุว่าเน้น AI inference |
จุดเด่นของ Minions คือเอาแนวคิดเครื่องว่างมาผูกกับงาน AI ขององค์กรโดยตรง ส่วนการควบคุมสิทธิ์และความลับยังต้องแยก pool ตามทีมให้เหมาะสม.
จุดแข็งและข้อจำกัดที่เห็นจากสถาปัตยกรรมจริง
Minions ช่วยดึงงาน AI ที่ค้างคิว GPU มารันบน Mac ว่าง ทำให้เวลารอจากคิวเกิน 10 ชั่วโมงลดลงเหลือระดับไม่กี่นาที แถมไม่ต้องขอ GPU ใหม่ ลดค่าโครงสร้างพื้นฐาน และขยายระบบตามจำนวนเครื่องที่เข้าร่วมได้
ข้อจำกัดคือรองรับเฉพาะ AI inference บน Apple Silicon และแต่ละ Mac ต้องรันโมเดลทั้งตัวบนเครื่องเดียว ไม่ได้แบ่งโมเดลข้ามหลายเครื่อง อีกด้านยังมีความกังวลเรื่องข้อมูลภายในองค์กร รวมถึงค่าไฟและการสึกหรอของ hardware ที่ยังไม่ถูกนับรวม.
ค่าใช้จ่ายที่ไม่ได้หายไปพร้อมกับคิว GPU
แม้ระบบจะระบุว่าต้นทุนโครงสร้างพื้นฐานเป็นศูนย์ แต่ค่าไฟฟ้าและการสึกหรอของฮาร์ดแวร์ยังไม่ได้ถูกนับรวม ต้นทุนส่วนนี้จึงไม่ได้หายไป แค่ไม่ปรากฏในค่า GPU โดยตรง
นอกจากนี้ เจ้าของ Mac อาจต้องหยุด Minion Executor เพื่อกลับมาใช้เครื่องเอง งานที่กำลังทำจะถูกส่งกลับเข้าคิว ทำให้การประหยัดต้นทุนต้องแลกกับความพร้อมใช้งานของเครื่องด้วย
ข้อมูลลับจะเดินทางไปอยู่ที่ Mac ของใคร
ความกังวลหลักคือข้อมูลของทีมอาจไปรันบน Mac ที่อยู่นอกกลุ่ม แม้ทุกเครื่องจะอยู่ในเครือข่ายภายในเดียวกันก็ตาม โดยเฉพาะงานภายในที่ยังต้องรักษาความลับ
Apple ลดความเสี่ยงด้วยการแยก deployment ตามทีมและองค์กร แต่ละกลุ่มมีฐานข้อมูลของตัวเอง และใช้ pool ของ Mac แยกกัน ทำให้กำหนดขอบเขตของงานกับอุปกรณ์ที่รับงานได้ชัดเจนขึ้น
จุดที่ควรจับตาหาก Apple ขยาย Minions ต่อไป
Minions สะท้อนว่า compute กลายเป็นคอขวดของงาน AI อย่างชัดเจน งานบางส่วนที่เคยรอคิว GPU เกิน 10 ชั่วโมง อาจกระจายไปรันบน Mac ที่มีอยู่แล้ว และลดเวลารอเหลือระดับนาทีได้
อย่างไรก็ตาม ระบบนี้ทำเฉพาะ AI inference โดยให้แต่ละ Mac รัน model ทั้งชุดบนเครื่องตัวเอง จึงยังต้องติดตามข้อจำกัดด้านกำลังประมวลผล รวมถึงค่าไฟฟ้าและอายุการใช้งานฮาร์ดแวร์ที่ยังไม่ได้รวมไว้ในต้นทุนของระบบ.